flowchart LR
    subgraph OverlapScheme["DeepEP Mega-MoE 计算与通信完全重叠流水线 (Compute-Comm Overlapping)"]
        direction TB
        subgraph StreamComm["通信流 (专用 20 SMs,异步执行)"]
            CommDispatch["MoE Layer L: 路由 Dispatch 通信"]
            CommCombine["MoE Layer L: 专家 Combine 通信"]
        end

        subgraph StreamComp["计算流 (独占 110 SMs,全速推进)"]
            CompShared["MoE Layer L: 共享专家 GEMM / Dense Attention"]
            CompNext["MoE Layer L+1: 预处理 LayerNorm / QKV 投影 GEMM"]
        end

        CommDispatch -.->|时间窗口完全重叠| CompShared
        CommCombine -.->|时间窗口完全重叠| CompNext
    end
第 14 课:DeepSeek DeepEP 核心架构与 MoE 专家并行通信算子拆解
参考答案版:包含完整代码实现与问答题深度参考解析。建议先独立完成练习题后再展开核对。
本课目标与完成标准
学完后你应能:
- 深刻理解大模型 MoE(Mixture of Experts)在集群规模扩展下的通信瓶颈(All-to-All Dispatch & Combine);
- 掌握 DeepSeek 开源 MoE 通信库 DeepEP 的核心架构与设计哲学,说清其颠覆传统 NCCL 的技术关键;
- 剖析 DeepEP 的两大核心引擎:高吞吐普通模式(High-Throughput Normal Mode) 与 低延迟推理模式(Low-Latency Mode);
- 掌握 SM 算力分区(SM Resource Partitioning)与“计算-通信完全重叠”(Mega-MoE Overlapping)的实现机理;
- 理解跨机分层调度(Hierarchical All-to-All:NVLink 节点内 + RDMA 节点间)与 CUDA Graph 零开销静态绑定的精髓。
通过必须同时满足:
- 独立补齐本课唯一的代码填空题(MoE 专家路由分发 Dispatch 与加权合并 Combine 核心算子模拟),并通过测试断言;
- 三个问答题均说明因果链与硬件交互逻辑,拒绝空洞术语;
- 能讲清至少一个通信正确性边界与性能权衡(如 SM 占用量与 GEMM 算力竞争);
- 总分不低于 8/10,且无一票否决级概念错误。
前置关系
- 课程前置:第 10 课:共享内存 Tiled GEMM、第 13 课:DeepSeek DeepGEMM 核心架构、分布式通信基础(AllReduce/All-to-All、RDMA、NVLink)。
- 本课在路线中的作用:与第 13 课 DeepGEMM 形成“算子+通信”合力,完整拼齐 DeepSeek-V3 / R1 核心分布式系统的底层基石。
核心心智模型
1. 它是什么,解决什么问题(如图 14-1 所示)
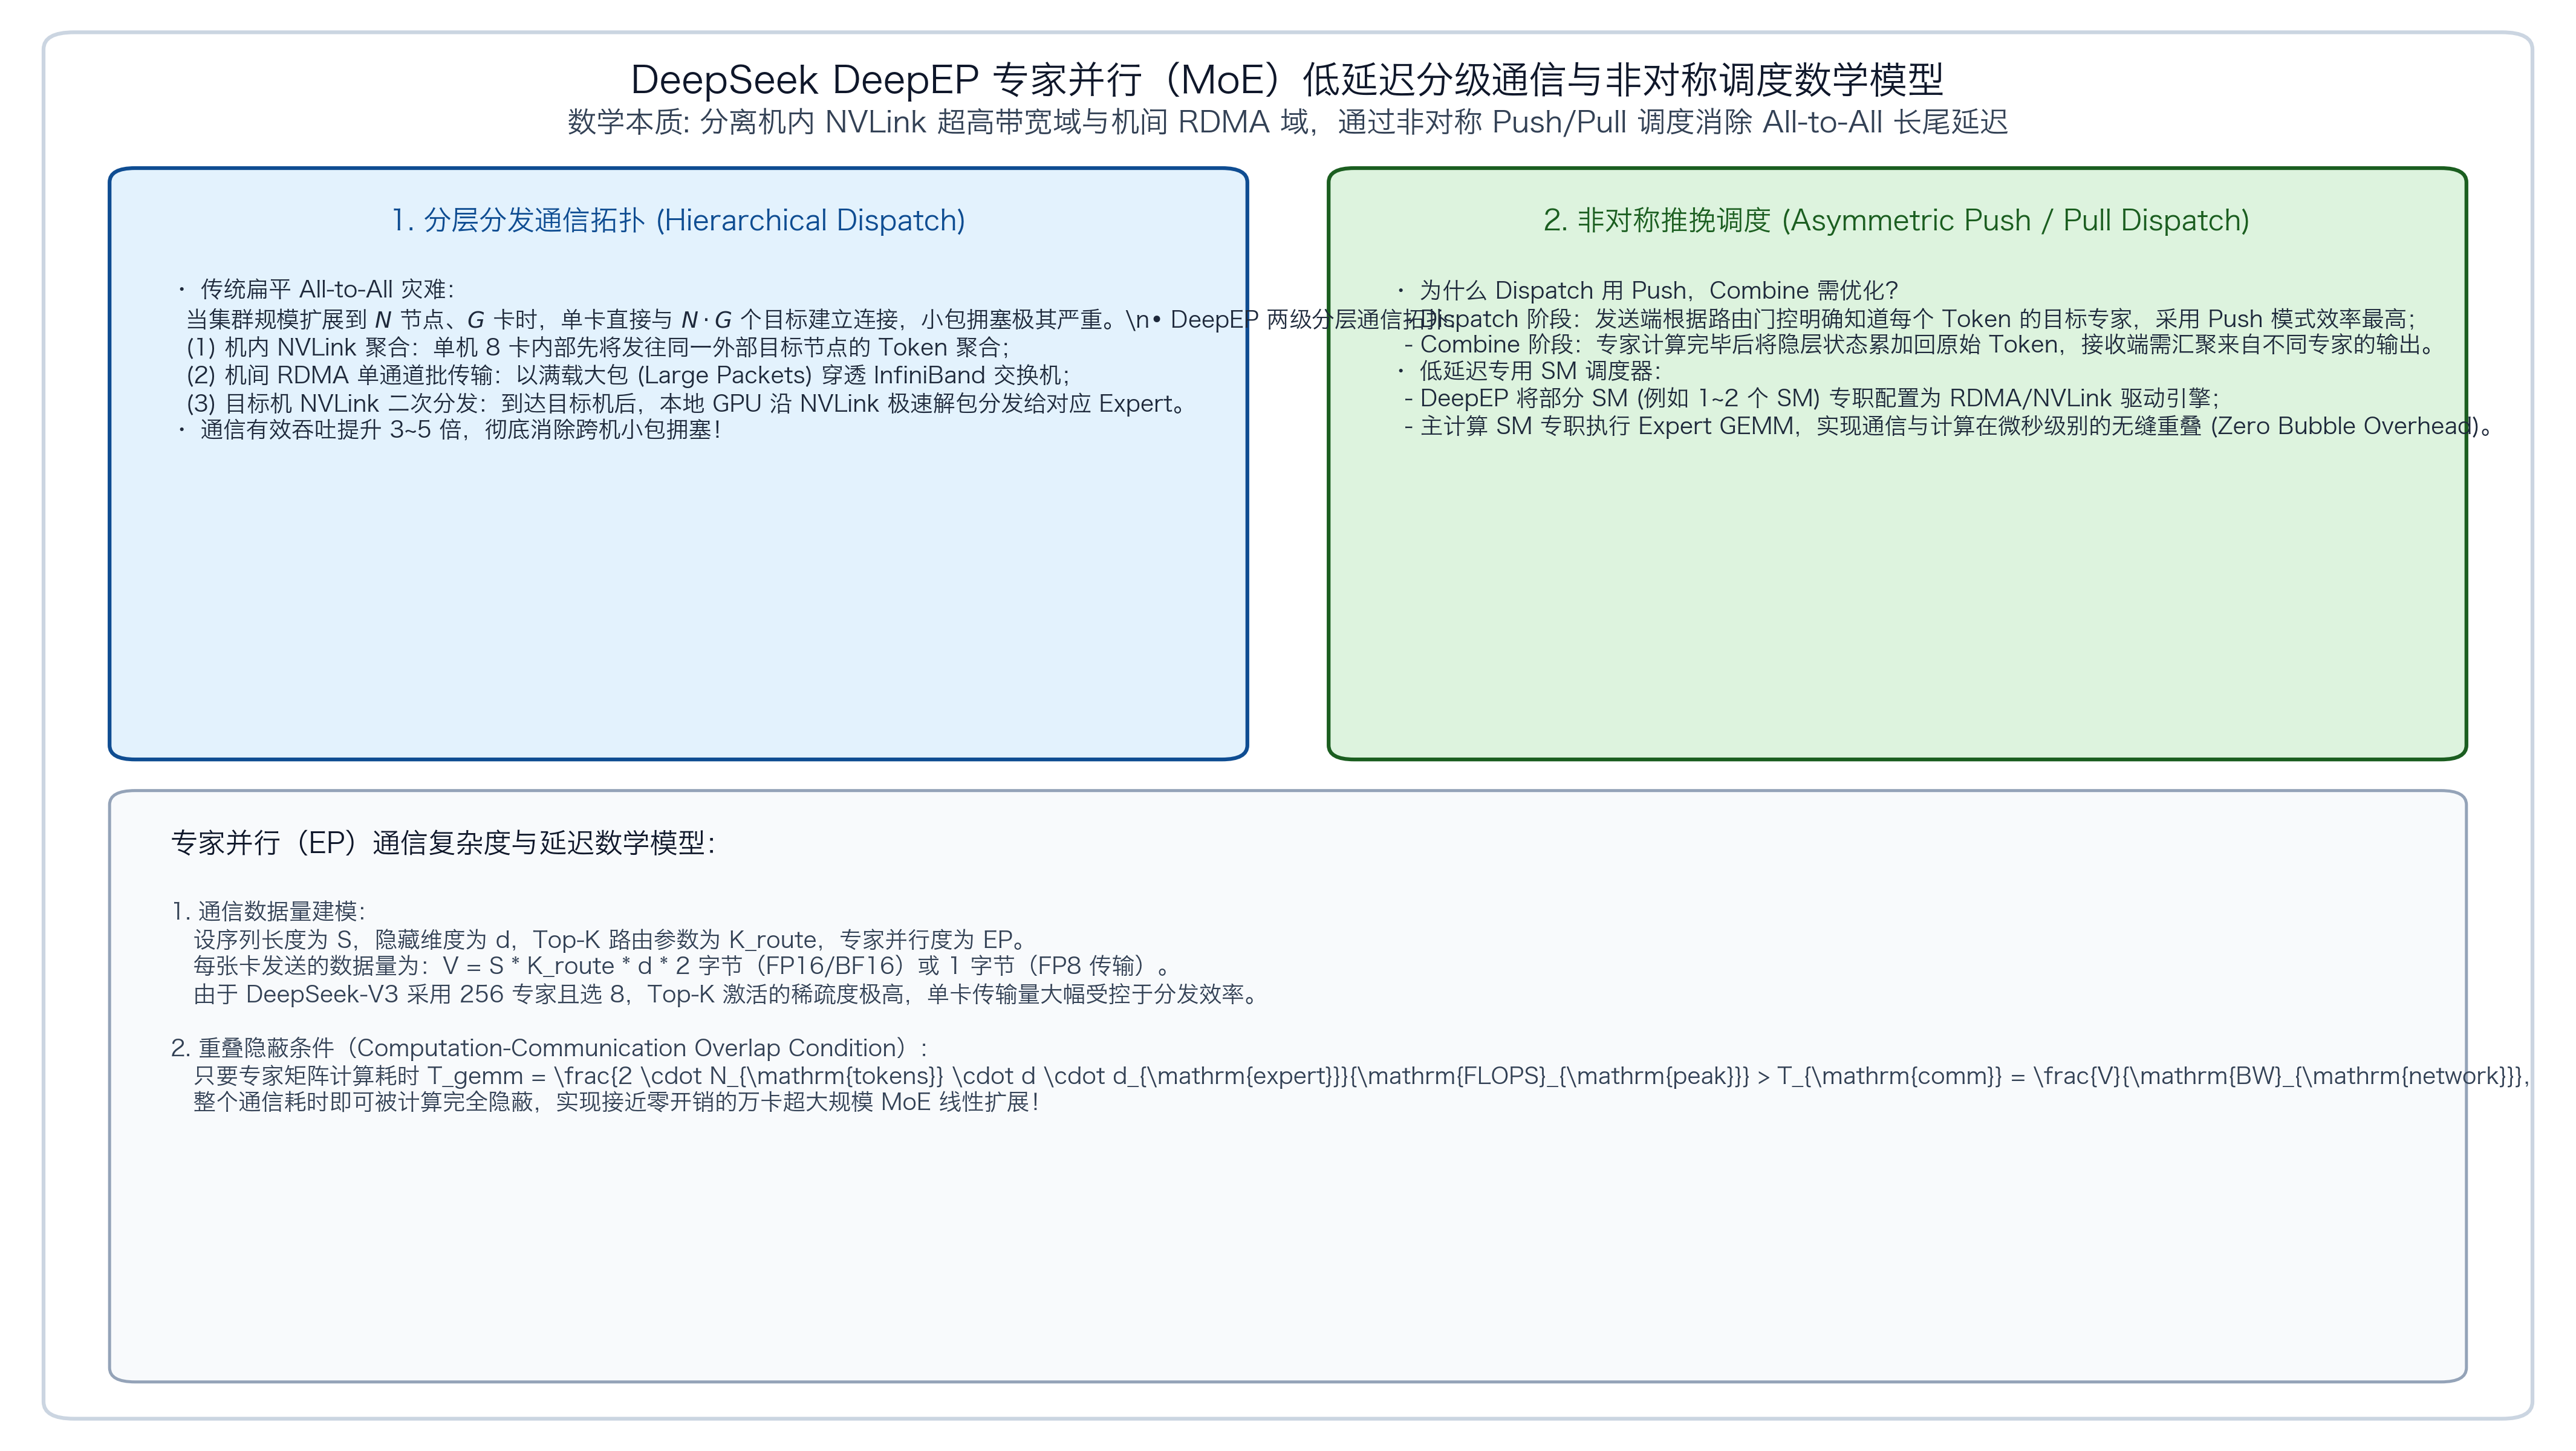
图 14-1:DeepSeek DeepEP 专家并行(MoE)低延迟分级通信与非对称调度数学模型
DeepEP 是 DeepSeek 专门为超大规模混合专家模型(MoE,如 DeepSeek-V3 / R1 / V2)打造的首个开源专用 EP(Expert Parallelism)通信库。
(1) 传统 MoE 分布式训练与推理的通信灾难
DeepSeek-V3 拥有 671B 参数,采用了极度细粒度的路由机制:总共 256 个路由专家 + 1 个共享专家,每个 Token 动态激活 Top-8 个专家。当集群规模达到数百乃至数千张 GPU 时,专家被切分在不同物理节点上:
- NCCL
all_to_allv的巨大延迟开销:- NCCL 作为通用通信原语,依赖 Host 端 CPU 发起,每次 Launch 开销高达 ;
- 在推理 Decoding 阶段(Batch 较小,每个 Token 仅几十微秒的 GEMM 计算),通信 Launch 开销甚至超过了计算本身,导致 GPU 发生大量同步空转。
- 动态 Token 数量破坏 CUDA Graph 捕获:
- 每个 Expert 接收到的 Token 数因数据分布动态变化。传统做法需要 CPU 介入统计偏移行数并重新下发变长张量,彻底摧毁了推理引擎的 CUDA Graph 静态执行图。
- 节点内 NVLink 与跨机 RDMA 无法高效分层流水:
- 扁平的 All-to-All 使得跨机网络带宽与卡间 NVLink 带宽发生拥塞短板效应,无法跑满硬件物理上限。
(2) DeepEP 的革命性突破
- 纯 GPU SM 驱动的低延迟内核(Low-Latency Kernel):完全绕过 CPU 与 NCCL。GPU 线程直接发起 NVLink 内存读写和 GPUDirect RDMA 网络事务,将通信延迟压至微秒级()!
- CUDA Graph 原生兼容(零 CPU 介入):在解码阶段通过预分配静态缓冲区与掩码标记,全流程由 GPU 硬件自主完成路由寻址与同步,完美与 CUDA Graph 融为一体;
- 非对称 SM 分区与完全重叠流水线(如图 14-3** 所示):精确固定占用 20 个左右的 SM 执行通信,其余 100+ 个 SM 持续全速计算,奠定了 DeepSeek-V3 惊艳业界的 Mega-MoE 零通信开销掩盖**。
图 14-3:DeepEP 专用通信 SM 与主计算流在时间轴上的无气泡重叠机理
2. DeepEP 核心微架构与算法剖析
(1) 双模引擎设计(Dual-Engine Architecture)
DeepEP 针对训练与推理的不同吞吐特征,实现了两套独立的算子流水线:
| 维度 | 普通高吞吐模式(Normal Mode) | 低延迟模式(Low-Latency Mode) |
|---|---|---|
| 主要应用场景 | 离线训练(Training)与推理首字填充(Prefill) | 推理逐字生成(Decoding)与低延迟服务 |
| 数据吞吐特征 | 大 Batch、长序列、Token 吞吐量巨大 | 小 Batch(1~128 tokens)、对时延极端敏感 |
| 底层硬件通道 | 显存 Buffer + NVLink / 跨机 RDMA 大包多通道并发 | 纯 SM 寄存器/SMem 直写 NVLink P2P + 硬件原子操作 |
| CPU 介入度 | 极小(异步流水调度) | 绝对零介入(Pure GPU Hardware-Driven) |
| CUDA Graph 支持 | 支持静态变体 | 100% 静态兼容,无动态分配 |
(2) 低延迟引擎(Low-Latency Engine)微架构细节
在 Low-Latency 模式下,GPU 节点间的 NVLink 充当了一块“全局统一编址内存(Unified Memory Fabric)”:
- P2P 硬件原子标记:源 GPU 的 SM 在向目标 GPU 的全局显存写入 Token 字节流后,利用 NVLink 远程原子指令(
atomicAdd或带 release 语义的 memory fence)在目标卡上的控制槽位加 1; - 目标卡自旋等待(Spinning Barrier):目标卡上的消费者 SM 直接在 L2 Cache / SMem 级别对控制槽位进行自旋轮询(
ld.volatile),一旦数据到达即刻启动计算,延迟降低到不可思议的 !
(3) 分层 All-to-All(Hierarchical All-to-All)与两跳路由
对于跨节点集群(例如 8 卡/节点):
- 节点内(Intra-node):具备高达 双向带宽的 NVLink;
- 节点间(Inter-node):受限于网卡带宽(如 )。
- 两跳代理路由机制:DeepEP 将发往同一远程节点的跨机 Token 先在本地节点内通过 NVLink 汇总到特定的网卡代理卡(Proxy Rank),由网卡高效打包发起 RDMA 发送;到达目标节点后,再经由目标节点内部的 NVLink 广播至相应专家卡,彻底消除远端跨机网卡的随机散落小包,打满网络吞吐。
3. 核心代码架构解析:Dispatch 与 Combine 原语
以下代码展示了 DeepEP 核心通信算子的逻辑骨架与调用接口:
# DeepEP Python 核心 API 规范
import torch
import deep_ep

# 1. 初始化低延迟通信缓冲(支持 CUDA Graph)
buffer = deep_ep.Buffer(
    group=dist_group,
    num_nvl_bytes=128 * 1024 * 1024,  # NVLink 环形缓冲区
    num_rdma_bytes=256 * 1024 * 1024  # RDMA 跨机缓冲区
)

# 2. 低延迟 Token 分发(Dispatch)
# topk_idx: [num_tokens, num_topk] 各 Token 选中的全局专家索引
# x:        [num_tokens, hidden_dim] 输入激活值
recv_x, recv_topk_idx, recv_topk_weights, num_recv_tokens = buffer.low_latency_dispatch(
    x=x,
    topk_idx=topk_idx,
    topk_weights=topk_weights,
    num_max_dispatch_tokens_per_rank=max_capacity,
    is_async=True  # 异步非阻塞发射,释放主计算流
)

# 3. 本地专家执行计算(调用 DeepGEMM Masked 算子)
expert_out = deep_gemm.m_grouped_fp8_gemm_nt_masked(
    recv_x, expert_weights, mask=recv_mask
)

# 4. 专家输出合并汇聚(Combine)
# 将各专家计算出的隐藏状态拉回源卡,并完成 Top-K 权重乘加
final_hidden_states = buffer.low_latency_combine(
    x=expert_out,
    topk_idx=topk_idx,
    topk_weights=topk_weights,
    is_async=False
)
实践任务:唯一代码填空题
练习说明
请实现一个自包含的 MoE 专家并行路由与加权合并算子模拟器(MoE Token Dispatch & Combine Simulator):
- 输入 个 Token,每个 Token 拥有隐藏维度 ;
- 每个 Token 路由到 Top-()个专家,共有 个专家,每个专家有归属的虚拟 Rank;
- Dispatch 阶段:按照专家索引将 Token 数据打包,分发到对应专家的待处理队列中;
- Expert Compute 阶段:专家对接收到的 Token 执行简单的前向映射(仿 GEMM 运算:);
- Combine 阶段:将计算结果拉回原 Token 位置,并严格按照 Gating 权重执行归一化加权求和。
只能修改 TODO/______ 位置,不得删除断言或放宽通过条件。
Code
import numpy as np

def moe_dispatch(tokens, topk_idx, num_experts):
    """
    模拟 DeepEP Dispatch 阶段:将 Token 打包分配给各 Expert
    tokens:   [N, H]
    topk_idx: [N, K] (每个 token 选中的 expert 编号)
    返回:
      expert_inputs: dict {expert_id: list of (token_idx, token_vector)}
    """
    N, H = tokens.shape
    N_idx, K = topk_idx.shape
    assert N == N_idx

    expert_inputs = {e: [] for e in range(num_experts)}

    # TODO: 遍历所有 Token 与其 Top-K 路由目标,填入对应专家的输入队列
    for i in range(N):
        for k in range(K):
            e_id = topk_idx[i, k]
            # 存入 (原序列索引 i, 对应的 token 特征向量)
            ______

    return expert_inputs

def moe_combine(expert_outputs, topk_idx, topk_weights, N, H):
    """
    模拟 DeepEP Combine 阶段:接收各专家输出,按 Gating Weights 加权汇聚
    expert_outputs: dict {expert_id: list of (token_idx, output_vector)}
    topk_idx:       [N, K]
    topk_weights:   [N, K]
    返回:
      combined_out:   [N, H]
    """
    combined_out = np.zeros((N, H), dtype=np.float32)

    # 建立从 (token_idx, expert_id) 到输出结果的快速查找表
    result_map = {}
    for e_id, item_list in expert_outputs.items():
        for t_idx, out_vec in item_list:
            result_map[(t_idx, e_id)] = out_vec

    # TODO: 按照 topk_idx 与 topk_weights 完成原始 Token 的加权和
    for i in range(N):
        for k in range(topk_idx.shape[1]):
            e_id = topk_idx[i, k]
            weight = topk_weights[i, k]
            out_vec = result_map[(i, e_id)]
            combined_out[i] += ______

    return combined_out

# ----------------- 测试用例与端到端验证 -----------------
np.random.seed(42)
N, H, K, E = 4, 4, 2, 4

# 生成虚拟输入
tokens = np.random.randn(N, H).astype(np.float32)
# 每个 token 随机选 2 个不重复的专家
topk_idx = np.array([
    [0, 2],
    [1, 3],
    [0, 3],
    [1, 2]
], dtype=np.int32)

# 归一化 Softmax 门控权重
raw_weights = np.random.uniform(0.1, 1.0, size=(N, K))
topk_weights = (raw_weights / raw_weights.sum(axis=1, keepdims=True)).astype(np.float32)

# 专家权重矩阵(每个专家一个 H x H 线性变换)
expert_weights = {e: np.random.randn(H, H).astype(np.float32) for e in range(E)}

# 1. 运行 Dispatch
dispatched = moe_dispatch(tokens, topk_idx, num_experts=E)
assert sum(len(v) for v in dispatched.values()) == N * K, "总分发量必须等于 N * K"

# 2. 执行专家计算
expert_outputs = {}
for e, items in dispatched.items():
    expert_outputs[e] = []
    for t_idx, vec in items:
        out_vec = np.matmul(vec, expert_weights[e])
        expert_outputs[e].append((t_idx, out_vec))

# 3. 运行 Combine
combined = moe_combine(expert_outputs, topk_idx, topk_weights, N, H)

# 4. 黄金参考标杆 (单机稠密基准对比)
ref_out = np.zeros((N, H), dtype=np.float32)
for i in range(N):
    for k in range(K):
        e = topk_idx[i, k]
        w = topk_weights[i, k]
        ref_out[i] += w * np.matmul(tokens[i], expert_weights[e])

assert np.allclose(combined, ref_out, atol=1e-5), "MoE Dispatch & Combine 数学等价性校验失败!"
print("DeepEP 核心调度流数学等价验证 100% 通过!")
检查方法
运行脚本验证断言通过;核对各专家处理 Token 总数与 N * K 守恒,确认加权汇聚结果与单机数学真值严格一致。
Q1
在 MoE 推理的 Decoding 阶段,为什么传统基于 CPU 发起的 NCCL all_to_allv 会造成严重的显卡算力空转(Bubbles)?DeepEP 的“纯 SM 驱动低延迟内核”是如何消除这一瓶颈的?
你的答案:
Q2
DeepEP 在架构设计上为何坚决采用非对称 SM 分区(固定分配 20~24 个 SM 专职通信),而不是让全部 SM(如 H800 的 132 个 SM)并发参与传输?这与 Mega-MoE 的计算重叠有什么直接因果联系?
你的答案:
Q3
面对跨多物理机节点的大规模集群,为什么扁平的 All-to-All 性能远逊于 DeepEP 的“分层两跳路由(Hierarchical 2-Hop)”?在面临不同专家负载偏斜(Load Imbalance / Straggler)时,系统是如何防范尾部延迟爆炸的?
你的答案:
评分与通过规则
- 代码 4 分:正确完成 Dispatch 索引映射与 Combine 加权和逻辑并跑通断言;
- Q1~Q3 各 2 分:必须结合微架构原语(CPU Launch 延迟、NVLink 硬件带宽、GPUDirect RDMA、SM 占用与计算并发)深入说明;
- 一票否决:混淆 Dispatch 与 Combine 的通信方向,或认为通讯必须占用全量 SM。