第 7 课:Online Softmax 与可结合状态

参考答案版:包含完整代码实现与问答题深度参考解析。建议先独立完成练习题后再展开核对。

本课目标与完成标准

学完后你应能:推导并实现 (m,d) 状态合并,为 FlashAttention 建立数值基础。

通过必须同时满足:

  • 独立补齐本课唯一的代码填空题,并通过给定检查;
  • 三个问答题均说明因果链,而不是只报术语;
  • 能指出至少一个正确性边界和一个性能取舍;
  • 总分不低于 8/10,且没有一票否决级概念错误。

前置关系

  • 课程前置:C/C++、线性代数、基本并行编程
  • 本课在路线中的作用:Online softmax 用最大值 m 与重标定分母 d 描述一个分片,使分片能流式合并而无需保存所有 logits。

核心心智模型

1. 它是什么,解决什么问题

Online Softmax(在线流式 Softmax,由 Milakov & Gimelshein 提出) 是一种将最大值追踪与分母累加融为一体的流式并行算法。

传统 3-Pass Softmax 的痛点: - 传统安全 Softmax 需要对数据进行整整 3 遍扫描:Pass 1 找全局最大值 m=max⁡xim = \max x_i;Pass 2 重新读入数据计算分母 d=∑exi−md = \sum e^{x_i - m};Pass 3 再读入数据除以 dd 输出结果。 - 在 Attention 机制中,中间激活矩阵 S=QKT∈ℝN×NS = QK^T \in \mathbb{R}^{N \times N} 容量巨大。如果必须等全局 NN 个得分算完才能做 Softmax,就必须把整个 N×NN \times N 矩阵写回高延迟的 HBM 显存,产生致命的显存容量瓶颈 O(N2)O(N^2) 与内存带宽墙。

Online Softmax 的核心突破: - 它证明了 Softmax 的状态可以用一个二元组 (m,d)(m, d) 完整描述,并构建了一个满足严格结合律与交换律的合并算子(Combine Operator); - 使得我们可以一边分块加载数据,一边动态更新局部最大值与指数和;不仅把独立的 Softmax 访存从 3-Pass 缩减为 2-Pass,更直接孕育了将矩阵乘法与 Softmax 深度融合的 FlashAttention 体系(图 7-1 至图 7-3)。

2. 它如何工作(结合图 7-1 至图 7-3)
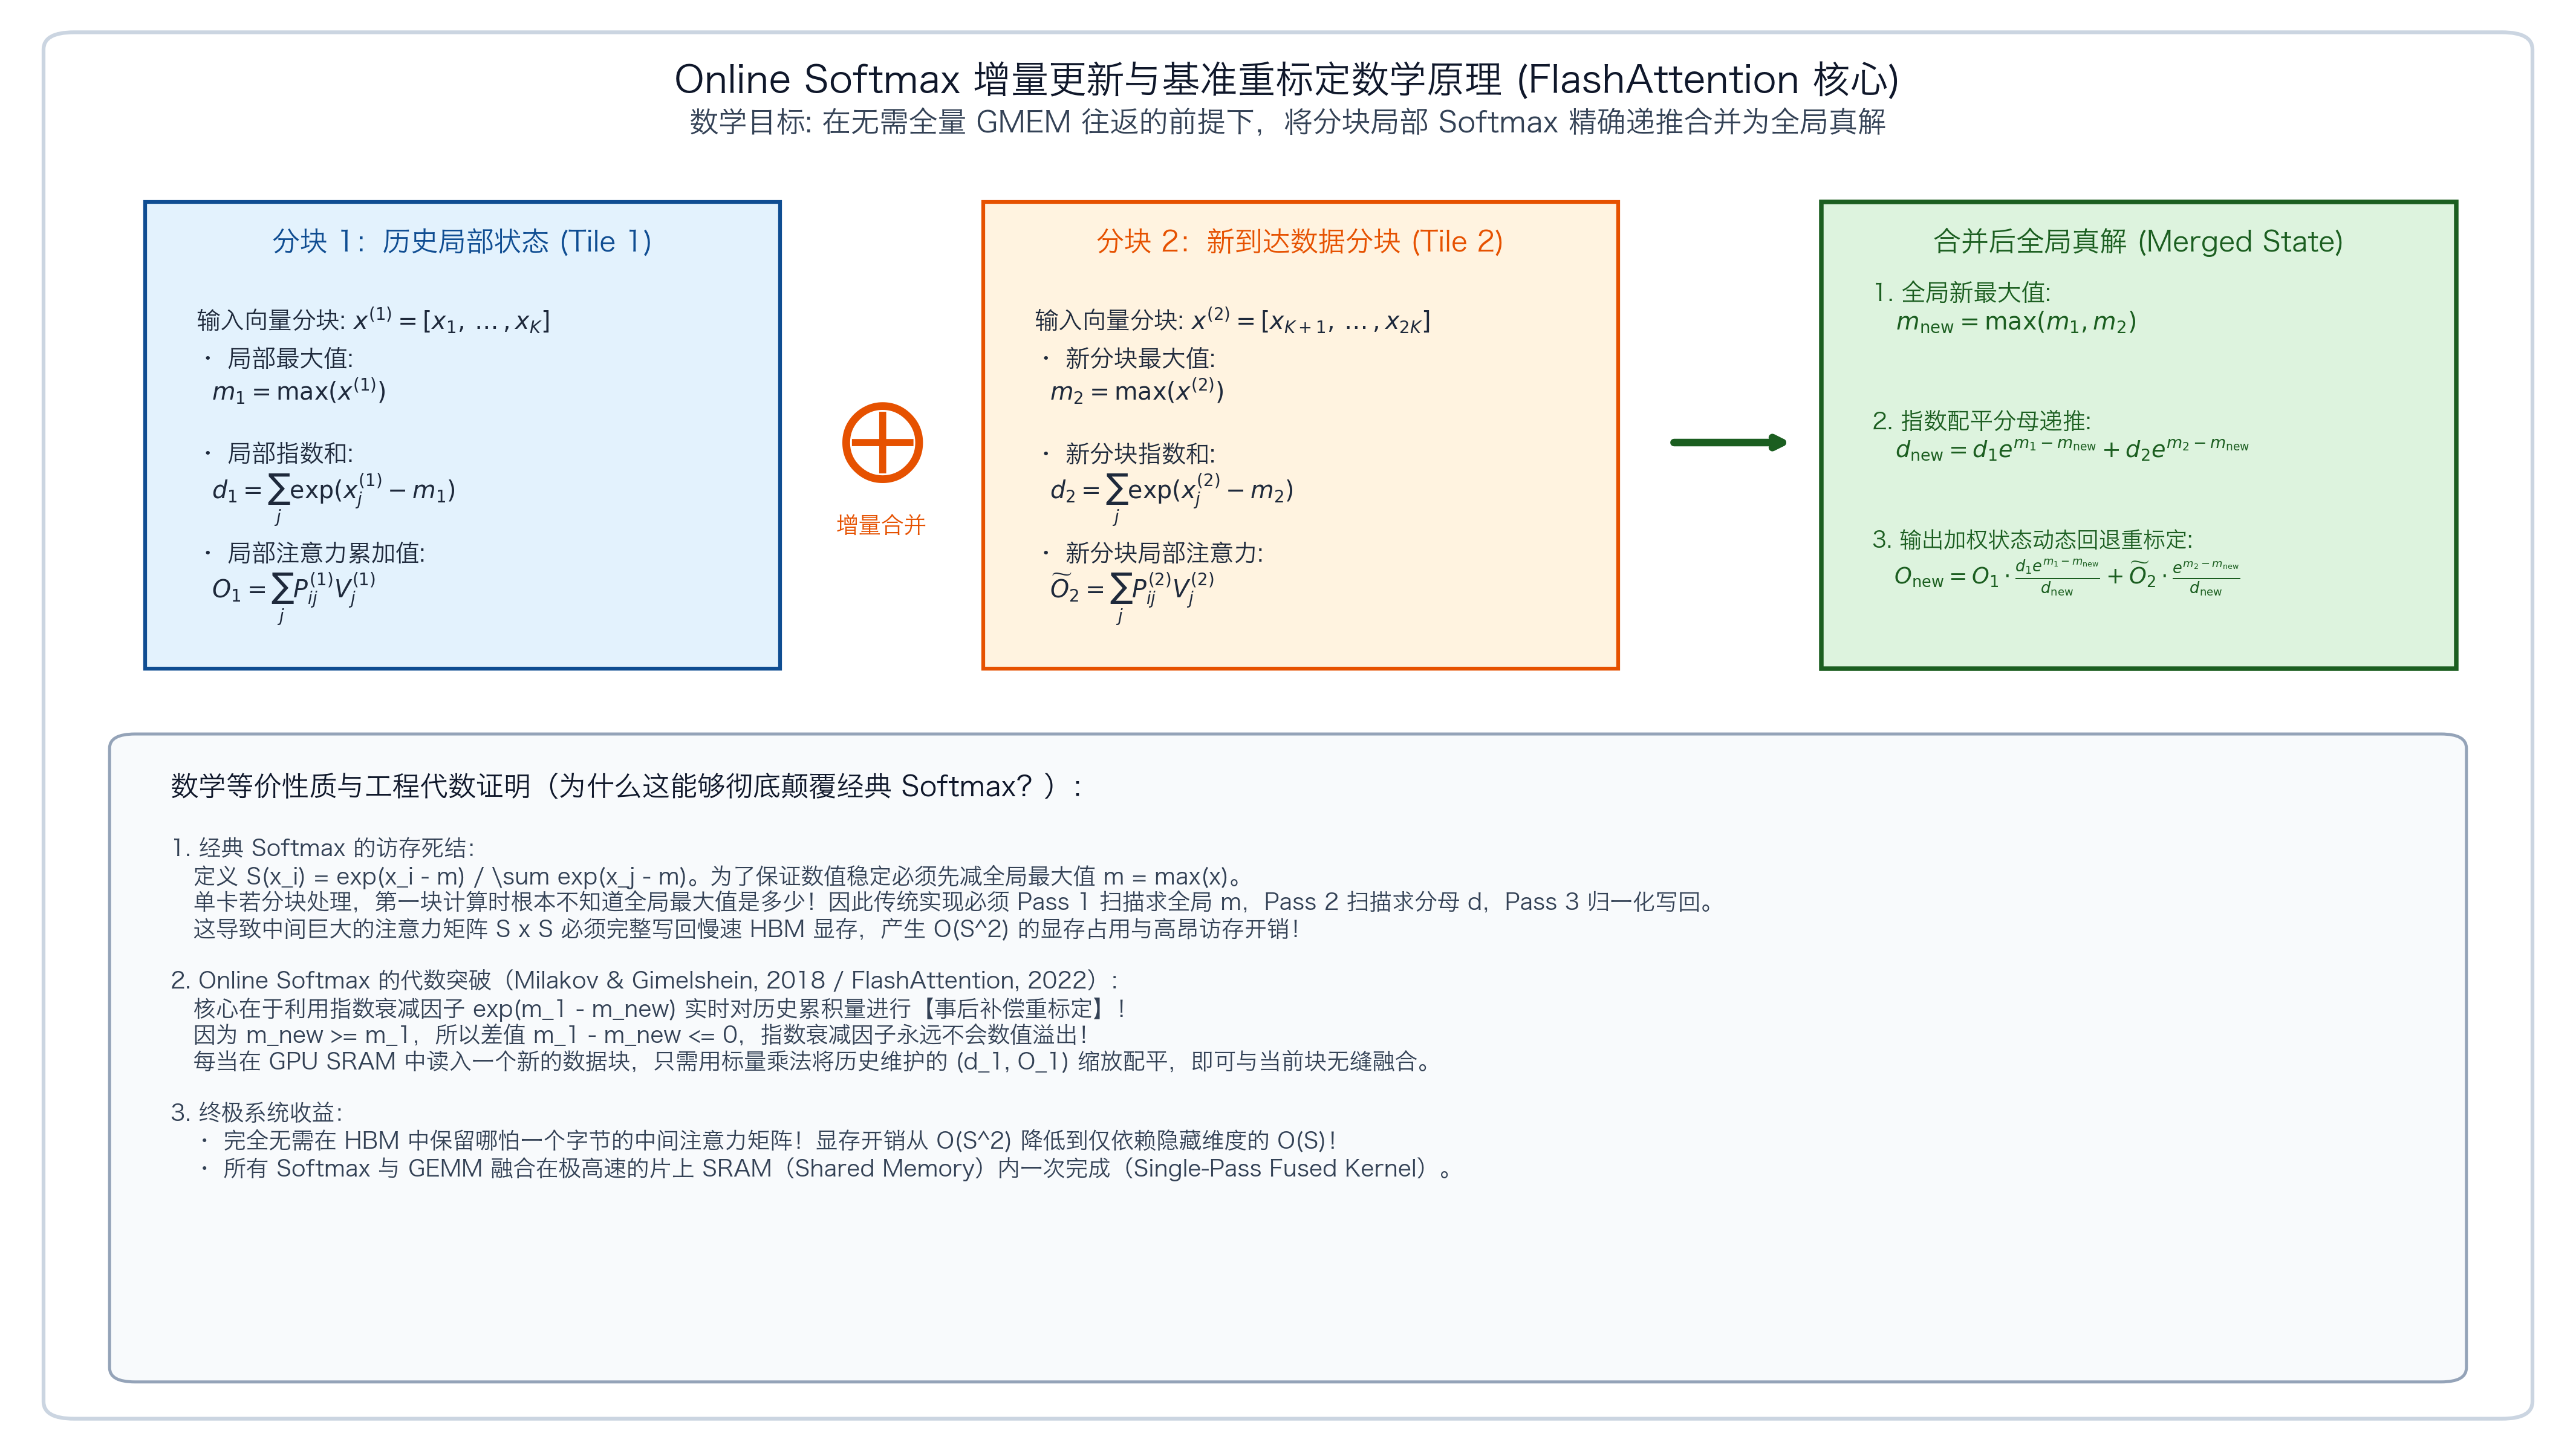
图 7-1:Online Softmax 增量更新、指数配平与基准重标定数学原理

flowchart LR
    subgraph OnlineCombine["Online Softmax 二元状态合并 Combine"]
        S1["分片 1: (m_1, d_1)"] --> Max["m_new = max(m_1, m_2)"]
        S2["分片 2: (m_2, d_2)"] --> Max
        Max --> Rescale["分母配平: d_new = d_1 * exp(m_1 - m_new) + d_2 * exp(m_2 - m_new)"]
        Rescale --> Out["合并新状态: (m_new, d_new)"]
    end

图 7-2:Online Softmax 可结合状态增量递推配平机制

flowchart TD
    Init["初始化: m = -INF, d = 0"] --> Load["分块加载瓦片输入"]
    Load --> Update["局部状态更新并在线 Combine"]
    Update --> Check{"是否遍历完全行?"}
    Check -->|是| Load
    Check -->|否| Final["除以最终累加和 d 得到准确输出,零中间 HBM 写回"]

图 7-3:单遍扫描 Online Softmax 增量更新与缩放流程

Online Softmax 的核心是维护一个可结合的二元统计状态 (m,d)(m, d):

  • mm:当前已遍历元素中的最大值;
  • d=∑x∈𝒮ex−md = \sum_{x \in \mathcal{S}} e^{x - m}:基于基准 mm 计算的指数归一化分母。

当需要合并两个互不相交的集合 𝒮1\mathcal{S}_1 与 𝒮2\mathcal{S}_2(对应的状态分别为 (m1,d1)(m_1, d_1) 与 (m2,d2)(m_2, d_2))时,状态转移公式如下:

  1. 更新全局最大值: mnew=max⁡(m1,m2)m_{new} = \max(m_1, m_2)

  2. 基准重标定与分母配平(Rescaling & Summing): dnew=d1⋅em1−mnew+d2⋅em2−mnewd_{new} = d_1 \cdot e^{m_1 - m_{new}} + d_2 \cdot e^{m_2 - m_{new}}

    • 若 m1≥m2m_1 \ge m_2,则 m1−mnew=0⟹e0=1m_1 - m_{new} = 0 \implies e^0 = 1,d1d_1 保持不变,只需将 d2d_2 乘以修正衰减因子 em2−m1e^{m_2 - m_1};
    • 对称地,若 m2>m1m_2 > m_1,则 d2d_2 保持不变,d1d_1 乘以 em1−m2e^{m_1 - m_2}。
  3. 分层归约与 2-Pass 执行流程:

    • Pass 1(单遍提取统揽全局):每个线程利用上述公式在线累加局部得分,得到每个线程的 (m,d)(m, d);随后通过 __shfl_down_sync 进行 Warp 内树状 Combine,再通过 Shared Memory 进行 Block 间二次 Combine,仅需一次全行扫描即同时得到整行全局精确的 mm 与 dd;
    • Pass 2(最终写回):线程再次读取输入,直接计算 yi=exi−mdy_i = \frac{e^{x_i - m}}{d} 写回显存。

3. 正确性条件与常见误区

  1. 分母历史配平必须与最大值更新严格原子同步:
    • 绝不能先更新 m←mnewm \leftarrow m_{new},然后用新的 mm 去重标定旧分母!如果执行 m1 = max(m1, m2); d1 = d1 * exp(m1 - m);,此时由于 m1 已经被覆写为 m,指数差变成 00,导致历史分母未做任何衰减,最终累加出的分母严重偏大,计算出的概率和远小于 1;
  2. 状态单位元(Identity Element)的数学严谨性:
    • Online Softmax 状态结合律的单位元必须严格定义为: (mid,did)=(−∞,0.0)(m_{\text{id}}, d_{\text{id}}) = (-\infty, 0.0)
    • 任何合法状态 (m,d)(m, d) 与单位元合并,max⁡(m,−∞)=m\max(m, -\infty) = m,d⋅e0+0⋅e−∞=dd \cdot e^0 + 0 \cdot e^{-\infty} = d,保持原有状态不变。初始化时未读取任何数据的寄存器必须置为 (-FLT_MAX, 0.0f)。

4. 性能与工程取舍

  1. 访存减少 vs. 指令开销(IO-bound 场景下的权衡):
    • 相比 3-Pass 算子,Online Softmax 在第一遍扫描中每个合并步都需要额外计算浮点比较 fmaxf 与指数修正 expf,ALU 算术指令数有所增加;
    • 但因为 GPU 显存带宽(HBM Bandwidth)远比片上计算单元稀缺,将访存遍数从 3 遍降低为 2 遍减少了整整一次全局显存读入流量,在实际生产环境中能带来 30%~50% 的确定性端到端加速;
  2. FlashAttention 融合扩展(0-Pass 显存写回):
    • 在本课的 2-Pass Softmax 中,Pass 2 依然需要读写独立显存;
    • 但在 FlashAttention 中,Online Softmax 与前后两次 GEMM(QKTQK^T 和 PVP V)彻底融合在同一个 SRAM 缓存流水线中,通过将未归一化的输出累加向量 OO 与 (m,d)(m, d) 一起在线重标定,彻底消除了中间注意力矩阵的 Global Memory 读写,使显存复杂度直接由 O(N2)O(N^2) 降低到 O(N)O(N)。

具体演示:两分片在线状态合并微观演算

假设某行被切分为两个分片:分片 A 为 [1.0,2.0][1.0, 2.0],分片 B 为 [3.0][3.0]:

  1. 分片 A 独立状态计算:
    • 最大值 mA=max⁡(1.0,2.0)=2.0m_A = \max(1.0, 2.0) = 2.0;
    • 局部指数和 dA=e1.0−2.0+e2.0−2.0=e−1+1.0≈0.367879+1.0=1.367879d_A = e^{1.0 - 2.0} + e^{2.0 - 2.0} = e^{-1} + 1.0 \approx 0.367879 + 1.0 = 1.367879;
    • 局部状态为 (mA,dA)=(2.0,1.367879)(m_A, d_A) = (2.0, 1.367879)。
  2. 分片 B 独立状态计算:
    • 最大值 mB=3.0m_B = 3.0;
    • 局部指数和 dB=e3.0−3.0=1.0d_B = e^{3.0 - 3.0} = 1.0;
    • 局部状态为 (mB,dB)=(3.0,1.0)(m_B, d_B) = (3.0, 1.0)。
  3. 执行 Online Combine:
    • 新全局最大值 mAB=max⁡(mA,mB)=max⁡(2.0,3.0)=3.0m_{AB} = \max(m_A, m_B) = \max(2.0, 3.0) = 3.0;
    • 配平累加分母: dAB=dA⋅emA−mAB+dB⋅emB−mAB=1.367879⋅e2−3+1.0⋅e3−3d_{AB} = d_A \cdot e^{m_A - m_{AB}} + d_B \cdot e^{m_B - m_{AB}} = 1.367879 \cdot e^{2 - 3} + 1.0 \cdot e^{3 - 3} dAB=1.367879⋅e−1+1.0⋅1.0≈1.367879×0.367879+1.0≈0.503214+1.0=1.503214d_{AB} = 1.367879 \cdot e^{-1} + 1.0 \cdot 1.0 \approx 1.367879 \times 0.367879 + 1.0 \approx 0.503214 + 1.0 = 1.503214
  4. 与全局 3-Pass 结果精确对验:
    • 全局数据 [1.0,2.0,3.0][1.0, 2.0, 3.0],全局最大值 m=3.0m = 3.0;
    • 全局分母 d=e1−3+e2−3+e3−3=e−2+e−1+1≈0.135335+0.367879+1.0=1.503214d = e^{1-3} + e^{2-3} + e^{3-3} = e^{-2} + e^{-1} + 1 \approx 0.135335 + 0.367879 + 1.0 = 1.503214;
    • 两者数值完全丝毫不差!这精确展示了 Online Softmax 如何在不保留历史原始得分的情况下实现无损融合。

实践任务:唯一代码填空题

补齐 online combine。

规则:只能修改 TODO/______ 所在位置;不要删除断言或放宽误差。代码注释说明了每个边界条件。

Code
%%writefile /tmp/07_online_softmax.cu
#include <float.h>
#include <cuda_runtime.h>

// Online Softmax 里每个局部状态用两个数表示:
// m = 当前看过元素的最大值
// d = sum(exp(x_i - m))
//
// 如果两个分片状态分别是 (m1, d1) 和 (m2, d2),合并时新的最大值是:
// m = max(m1, m2)
//
// 原来的 d1 基于 m1,d2 基于 m2;合并到新 m 后需要重新缩放:
// d = d1 * exp(m1 - m) + d2 * exp(m2 - m)
//
// 这个合并公式是 online softmax 的核心。
__device__ __forceinline__ void online_combine(
    float& m1,
    float& d1,
    float m2,
    float d2
) {
    float m = fmaxf(m1, m2);
    d1 = ______;  // TODO: 把两个分母重标到新最大值
    m1 = m;
}

// warp 内把 32 个线程各自的 (m, d) 合并成一个状态。
// shuffle_down 每次把 offset 位置的线程状态读过来,然后用 online_combine 合并。
__device__ __forceinline__ void warp_reduce_online(float& m, float& d) {
    unsigned mask = 0xffffffff;

    #pragma unroll
    for (int offset = 16; offset > 0; offset >>= 1) {
        float m2 = __shfl_down_sync(mask, m, offset);
        float d2 = __shfl_down_sync(mask, d, offset);
        online_combine(m, d, m2, d2);
    }
}

// Softmax: 对 [M, N] 的每一行做 softmax。
//
// 传统稳定 softmax 通常是 3 pass:
// 1. 求 max
// 2. 求 sum(exp(x - max))
// 3. 写 output
//
// 这个版本是 2 pass online softmax:
// 1. 一次扫描同时得到整行 max 和 denominator
// 2. 第二次扫描写 output
//
// 一个 block 负责一行。这样一行的 max/sum 只算一次,
// 避免“每个输出元素都重复扫整行”的 O(N^2) 写法。
template<int BLOCK_SIZE>
__global__ void softmax_online_2pass(
    const float* __restrict__ input,
    float* __restrict__ output,
    int M,
    int N
) {
    int row = blockIdx.x;
    int tid = threadIdx.x;

    if (row >= M) return;

    const float* row_in = input + row * N;
    float* row_out = output + row * N;

    // 每个线程维护自己负责列的 online 状态。
    float local_m = -FLT_MAX;
    float local_d = 0.0f;

    // Pass 1:每个线程 stride 扫一部分列。
    // 对新元素 x,把当前状态 (local_m, local_d) 和单元素状态 (x, 1) 合并。
    for (int col = tid; col < N; col += BLOCK_SIZE) {
        float x = row_in[col];

        float new_m = fmaxf(local_m, x);
        local_d = local_d * expf(local_m - new_m) + expf(x - new_m);
        local_m = new_m;
    }

    // 先在每个 warp 内合并 local 状态。
    warp_reduce_online(local_m, local_d);

    constexpr int NUM_WARPS = (BLOCK_SIZE + 31) / 32;

    __shared__ float smem_m[NUM_WARPS];
    __shared__ float smem_d[NUM_WARPS];

    int lane = tid & 31;
    int warp = tid >> 5;

    // 每个 warp 的 lane 0 把该 warp 的结果放到 shared memory。
    if (lane == 0) {
        smem_m[warp] = local_m;
        smem_d[warp] = local_d;
    }

    __syncthreads();

    // warp 0 负责把所有 warp 的 partial 状态合成整行状态。
    float row_m = -FLT_MAX;
    float row_d = 0.0f;

    if (warp == 0) {
        if (lane < NUM_WARPS) {
            row_m = smem_m[lane];
            row_d = smem_d[lane];
        }

        warp_reduce_online(row_m, row_d);

        // 把最终整行 max 和 denominator 广播用的数据写回 smem[0]。
        if (lane == 0) {
            smem_m[0] = row_m;
            smem_d[0] = row_d;
        }
    }

    __syncthreads();

    row_m = smem_m[0];
    row_d = smem_d[0];

    // Pass 2:整行 max 和 denominator 已知后,写最终 softmax。
    for (int col = tid; col < N; col += BLOCK_SIZE) {
        row_out[col] = expf(row_in[col] - row_m) / row_d;
    }
}

void launch_softmax_online_2pass(
    const float* input,
    float* output,
    int M,
    int N,
    cudaStream_t stream
) {
    constexpr int BLOCK_SIZE = 256;
    softmax_online_2pass<BLOCK_SIZE><<<M, BLOCK_SIZE, 0, stream>>>(
        input, output, M, N
    );
}

检查方法

有 CUDA 环境时执行 nvcc -std=c++17 -c /tmp/07_online_softmax.cu -o /tmp/07_online_softmax.cu.o;无 CUDA 环境时可运行下方纯 Python/NumPy 仿真单元进行结合律递推与数值边界验证。

无 GPU 环境纯 Python/NumPy 仿真验证(即时可运行)

若本地暂无 NVIDIA GPU 或 CUDA 工具链,可直接运行以下纯 Python 代码,模拟分块流式加载与 (m,d)(m, d) 在线 Rescale 配平更新:

Code
import numpy as np

def online_softmax_numpy_simulate(x_row, chunk_size=32):
    """纯 Python 模拟 GPU 线程块分块 Online Softmax (m, d) 结合律增量合并过程"""
    m = -np.inf
    d = 0.0
    N = len(x_row)
    # Pass 1: 模拟分块加载与在线 combine
    for start in range(0, N, chunk_size):
        chunk = x_row[start:min(start + chunk_size, N)]
        chunk_m = np.max(chunk)
        new_m = max(m, chunk_m)
        # 核心结合律公式: 历史旧分母重标定配平 + 新分块指数累加
        d = d * np.exp(m - new_m) + np.sum(np.exp(chunk - new_m))
        m = new_m
    # Pass 2: 归一化写出
    output = np.exp(x_row - m) / d
    return output

# 单元测试: 包含大数与极端负数
mock_input = np.array([1.0, 2.0, 10.0, 85.0, 87.0, -50.0], dtype=np.float32)
sim_output = online_softmax_numpy_simulate(mock_input, chunk_size=2)

# 与标准 Safe Softmax 严密对齐
safe_exp = np.exp(mock_input - np.max(mock_input))
expected_output = safe_exp / np.sum(safe_exp)
assert np.allclose(sim_output, expected_output, atol=1e-6), "Online Softmax 仿真数值偏离!"
assert np.isclose(np.sum(sim_output), 1.0, atol=1e-6), "概率归一化和不为 1!"
print("Online Softmax 跨平台纯 Python 仿真验证 100% 通过!")

提交时请给出:补齐后的代码、实际运行输出(环境不可用时注明“仅静态审查”)以及对失败用例的解释。

Q1

不要背定义:请从输入、状态变化和输出三个阶段解释“Online Softmax 与可结合状态”的工作机制。

你的答案:

Q2

如果更新 m 却不重标 d,softmax 和为何不再是 1?

你的答案:

Q3

这个二元状态如何扩展到带 value 累积的 attention 输出?

你的答案:

评分与通过规则

  • 代码 4 分:正常输入 2 分,边界输入 1 分,解释实现 1 分;
  • Q1~Q3 各 2 分;
  • 一票否决:结果碰巧正确但核心因果链错误、删除边界检查、把未运行结果说成实测。

需要提示时按四级机制请求:概念区域 → 具体方向 → 关键局部 → 完整答案。

参考答案(仅 answer 分支)

先完成题目再核对。即使代码一致,也要能解释关键步骤,并尝试更换一个输入规模。

Code
%%writefile /tmp/07_online_softmax.cu
#include <float.h>
#include <cuda_runtime.h>

// Online Softmax 里每个局部状态用两个数表示:
// m = 当前看过元素的最大值
// d = sum(exp(x_i - m))
//
// 如果两个分片状态分别是 (m1, d1) 和 (m2, d2),合并时新的最大值是:
// m = max(m1, m2)
//
// 原来的 d1 基于 m1,d2 基于 m2;合并到新 m 后需要重新缩放:
// d = d1 * exp(m1 - m) + d2 * exp(m2 - m)
//
// 这个合并公式是 online softmax 的核心。
__device__ __forceinline__ void online_combine(
    float& m1,
    float& d1,
    float m2,
    float d2
) {
    float m = fmaxf(m1, m2);
    d1 = d1 * expf(m1 - m) + d2 * expf(m2 - m);
    m1 = m;
}

// warp 内把 32 个线程各自的 (m, d) 合并成一个状态。
// shuffle_down 每次把 offset 位置的线程状态读过来,然后用 online_combine 合并。
__device__ __forceinline__ void warp_reduce_online(float& m, float& d) {
    unsigned mask = 0xffffffff;

    #pragma unroll
    for (int offset = 16; offset > 0; offset >>= 1) {
        float m2 = __shfl_down_sync(mask, m, offset);
        float d2 = __shfl_down_sync(mask, d, offset);
        online_combine(m, d, m2, d2);
    }
}

// Softmax: 对 [M, N] 的每一行做 softmax。
//
// 传统稳定 softmax 通常是 3 pass:
// 1. 求 max
// 2. 求 sum(exp(x - max))
// 3. 写 output
//
// 这个版本是 2 pass online softmax:
// 1. 一次扫描同时得到整行 max 和 denominator
// 2. 第二次扫描写 output
//
// 一个 block 负责一行。这样一行的 max/sum 只算一次,
// 避免“每个输出元素都重复扫整行”的 O(N^2) 写法。
template<int BLOCK_SIZE>
__global__ void softmax_online_2pass(
    const float* __restrict__ input,
    float* __restrict__ output,
    int M,
    int N
) {
    int row = blockIdx.x;
    int tid = threadIdx.x;

    if (row >= M) return;

    const float* row_in = input + row * N;
    float* row_out = output + row * N;

    // 每个线程维护自己负责列的 online 状态。
    float local_m = -FLT_MAX;
    float local_d = 0.0f;

    // Pass 1:每个线程 stride 扫一部分列。
    // 对新元素 x,把当前状态 (local_m, local_d) 和单元素状态 (x, 1) 合并。
    for (int col = tid; col < N; col += BLOCK_SIZE) {
        float x = row_in[col];

        float new_m = fmaxf(local_m, x);
        local_d = local_d * expf(local_m - new_m) + expf(x - new_m);
        local_m = new_m;
    }

    // 先在每个 warp 内合并 local 状态。
    warp_reduce_online(local_m, local_d);

    constexpr int NUM_WARPS = (BLOCK_SIZE + 31) / 32;

    __shared__ float smem_m[NUM_WARPS];
    __shared__ float smem_d[NUM_WARPS];

    int lane = tid & 31;
    int warp = tid >> 5;

    // 每个 warp 的 lane 0 把该 warp 的结果放到 shared memory。
    if (lane == 0) {
        smem_m[warp] = local_m;
        smem_d[warp] = local_d;
    }

    __syncthreads();

    // warp 0 负责把所有 warp 的 partial 状态合成整行状态。
    float row_m = -FLT_MAX;
    float row_d = 0.0f;

    if (warp == 0) {
        if (lane < NUM_WARPS) {
            row_m = smem_m[lane];
            row_d = smem_d[lane];
        }

        warp_reduce_online(row_m, row_d);

        // 把最终整行 max 和 denominator 广播用的数据写回 smem[0]。
        if (lane == 0) {
            smem_m[0] = row_m;
            smem_d[0] = row_d;
        }
    }

    __syncthreads();

    row_m = smem_m[0];
    row_d = smem_d[0];

    // Pass 2:整行 max 和 denominator 已知后,写最终 softmax。
    for (int col = tid; col < N; col += BLOCK_SIZE) {
        row_out[col] = expf(row_in[col] - row_m) / row_d;
    }
}

void launch_softmax_online_2pass(
    const float* input,
    float* output,
    int M,
    int N,
    cudaStream_t stream
) {
    constexpr int BLOCK_SIZE = 256;
    softmax_online_2pass<BLOCK_SIZE><<<M, BLOCK_SIZE, 0, stream>>>(
        input, output, M, N
    );
}

Q1 参考答案

  1. 输入阶段(Input Streaming & Local State Init):
    • 算法以 Block-per-Row 粒度并发,每个线程初始化本地二元状态为代数单位元 (m,d)=(−∞,0.0)(m, d) = (-\infty, 0.0);
    • 线程以 Grid-Stride 方式连续遍历自己所分配到的列元素 xix_i,对每个新输入与当前状态进行一次流式在线合并:若新输入更大,更新局部基准 m←max⁡(m,xi)m \leftarrow \max(m, x_i),并将历史分母配平缩放后加上新项 exi−me^{x_i - m};
  2. 状态变化阶段(Hierarchical Associative Reduction & Broadcast):
    • Warp 级折半归约:Warp 内 32 个线程利用 __shfl_down_sync 同时交换寄存器中的局部最大值 mm 和局部指数分母 dd,调用二元结合律算子 online_combine 在 5 步洗牌内完成 Warp 级配平合并;
    • Block 级二次归约:各 Warp 的 Lane 0 将局部的 (m,d)(m, d) 写入 Shared Memory,由 Warp 0 进行二次归约,在单遍扫描内直接得出整行全局真实的全局最大值 mglobalm_{\text{global}} 和全局归一化分母 dglobald_{\text{global}};
    • 结果广播与同步:Lane 0 将全局统计量存入共享内存标量槽位,执行 __syncthreads() 同步,使整个 ThreadBlock 拥有统一的全局归一化基准;
  3. 输出阶段(Pointwise Exponentiation & Normalization):
    • 线程执行 Pass 2,重新按跨步读取全局显存中的原始行数据 xix_i,直接计算最终 Softmax 概率值 yi=exp⁡(xi−mglobal)dglobaly_i = \frac{\exp(x_i - m_{\text{global}})}{d_{\text{global}}} 并合并写回显存。

Q2 参考答案

若更新了最大值 mm 却不重新对旧分母 dd 执行指数重标定(Rescaling),会导致 Softmax 输出概率和不再为 1,甚至引发灾难性的概率漂移:

  1. 数学推导与量纲失配:
    • 假设历史分母 dold=∑j∈pastexj−moldd_{old} = \sum_{j \in \text{past}} e^{x_j - m_{old}} 是以 moldm_{old} 为基准基线计算的;
    • 当遇到更大的元素使基准提升为 mnew>moldm_{new} > m_{old} 时,根据定义,所有历史项在新基准下的真实指数和应为: ∑j∈pastexj−mnew=∑j∈pastexj−mold+(mold−mnew)=emold−mnew∑j∈pastexj−mold=dold⋅emold−mnew\sum_{j \in \text{past}} e^{x_j - m_{new}} = \sum_{j \in \text{past}} e^{x_j - m_{old} + (m_{old} - m_{new})} = e^{m_{old} - m_{new}} \sum_{j \in \text{past}} e^{x_j - m_{old}} = d_{old} \cdot e^{m_{old} - m_{new}}
    • 如果不乘衰减因子 emold−mnew<1e^{m_{old} - m_{new}} < 1,历史分母 doldd_{old} 就仍然停留在旧基准尺度上;
  2. 分母被严重虚假放大:
    • 未经缩放的直接相加使得累加出的总分母 d̃=dold+∑k∈newexk−mnew\tilde{d} = d_{old} + \sum_{k \in \text{new}} e^{x_k - m_{new}} 远远大于在新基准 mnewm_{new} 下的真实分母;
    • 在输出阶段,分子统一按照新最大值平移计算 exi−mnewe^{x_i - m_{new}},此时分子之和严格等于真实分母 dtrued_{true},但除以的却是一个被虚假放大的 d̃\tilde{d};
    • 最终输出张量的概率之和将满足 ∑iyi=dtrued̃<1.0\sum_i y_i = \frac{d_{true}}{\tilde{d}} < 1.0。历史元素对应的概率被成倍压缩,完全丧失了 Softmax 概率归一化的数学有效性。

Q3 参考答案

将该二元状态扩展到带 Value 向量累加的自注意力机制输出正是 FlashAttention 的核心发明:

  1. 状态扩充为三元组 (m,d,𝒐)(m, d, \mathbf{o}):
    • 除了标量最大值 mm 和标量指数和 dd 外,在线程私有寄存器中额外维护一个未归一化的特征累积向量 𝒐∈ℝdv\mathbf{o} \in \mathbb{R}^{d_v}(初始为全 0 向量);
  2. 分块增量更新方程(FlashAttention 核心递推式):
    • 假设当前已累计状态为 (m(j−1),d(j−1),𝒐(j−1))(m^{(j-1)}, d^{(j-1)}, \mathbf{o}^{(j-1)}),从 HBM 加载下一个 Key-Value 分块 (Kj,Vj)(K_j, V_j) 到 SRAM;
    • 在 SRAM 中计算当前块的未归一化注意力得分切片 S(j)=QKjTS^{(j)} = Q K_j^T,并求出该块的局部最大值 m̃j=max⁡(S(j))\tilde{m}_j = \max(S^{(j)}) 和局部未归一化加权输出 P̃j=exp⁡(S(j)−m̃j)\tilde{P}_j = \exp(S^{(j)} - \tilde{m}_j);
    • 更新全局最大值:m(j)=max⁡(m(j−1),m̃j)m^{(j)} = \max(m^{(j-1)}, \tilde{m}_j);
    • 配平修正旧累积量并追加新块贡献: 𝒐(j)=𝒐(j−1)⋅em(j−1)−m(j)+exp⁡(S(j)−m(j))Vj\mathbf{o}^{(j)} = \mathbf{o}^{(j-1)} \cdot e^{m^{(j-1)} - m^{(j)}} + \exp(S^{(j)} - m^{(j)}) V_j d(j)=d(j−1)⋅em(j−1)−m(j)+∑exp⁡(S(j)−m(j))d^{(j)} = d^{(j-1)} \cdot e^{m^{(j-1)} - m^{(j)}} + \sum \exp(S^{(j)} - m^{(j)})
  3. 最终归一化输出(零中间 HBM 写入):
    • 当遍历完序列的所有 Key-Value 分块后,每个 Token 最终的 Attention 输出只需执行一次向量标量除法: 𝑶final=𝒐d\mathbf{O}_{\text{final}} = \frac{\mathbf{o}}{d}
    • 全程 N×NN \times N 的中间注意力得分矩阵完全在片上高速 SRAM/寄存器中完成配平与折算,根本无需向低速 HBM 写入任何中间矩阵,将 Attention 的显存空间复杂度从 O(N2)O(N^2) 降低到 O(N)O(N)。

参考资料

资料用于建立事实基线;面试回答仍需用自己的语言组织。