flowchart LR
    subgraph MoELayouts["DeepGEMM MoE 分组矩阵乘(Grouped GEMM)两类执行模式"]
        direction TB
        subgraph Contiguous["Contiguous Layout (训练 Forward/Backward & 推理 Prefill)"]
            Tokens["动态 Token 按 Expert 拼接 (M 维不规则)"] --> Align["M 维按 Tile 对齐 (M-alignment)"]
            Align --> KContig["K-Grouped TN / M-Grouped NT 算子执行"]
        end

        subgraph Masked["Masked Layout (推理 Decoding + CUDA Graph)"]
            FixedBuf["固定最大容量静态显存缓冲 (Zero-Allocation)"] --> MaskTensor["掩码张量 (Valid Mask Tensor)"]
            MaskTensor --> DeepEP_In["接收 DeepEP 低延迟通信产物"]
            DeepEP_In --> MaskedKernel["m_grouped_fp8_gemm_nt_masked 仅计算有效 Token"]
        end
    end
第 13 课:DeepSeek DeepGEMM 核心架构与 Hopper FP8 算子拆解
参考答案版:包含完整代码实现与问答题深度参考解析。建议先独立完成练习题后再展开核对。
本课目标与完成标准
学完后你应能:
- 深入推演 DeepSeek-V3 核心算子库 DeepGEMM 的设计动机,说清其相比传统 CUTLASS 3.x / cuBLASLt 的架构取舍;
- 掌握 Hopper 架构(SM90)的核心指令级原语:Tensor Memory Accelerator (TMA)、Warp-Group MMA (
wgmma.mma_async) 与mbarrier硬件事务屏障; - 彻底理清 Fine-grained Block-wise FP8 量化( 细粒度分块缩放)的数学原理与高效 Epilogue 反量化实现;
- 掌握 MoE 场景下 Contiguous Grouped GEMM 与 Masked Grouped GEMM 的调度机制及其与 DeepEP 通信库的协同。
通过必须同时满足:
- 独立补齐本课唯一的代码填空题(Hopper WGMMA + 细粒度反量化分块模拟内核),并通过给定测试断言;
- 三个问答题均说明因果链与硬件微架构状态迁移,而不是只报术语;
- 能指出至少一个正确性边界和一个性能瓶颈取舍;
- 总分不低于 8/10,且没有一票否决级概念错误。
前置关系
- 课程前置:第 10 课:共享内存 Tiled GEMM、CUDA 异步拷贝机制、计算机体系结构(SM/Shared Memory/Tensor Core)。
- 本课在路线中的作用:作为算子核心主线的现代化高阶实战课,将经典的 Shared Memory Tiling 跨越升级到现代 Hopper (SM90) / Blackwell (SM100) 的无寄存器搬运异步流水线与 MoE 定制 Grouped GEMM。
核心心智模型
1. 它是什么,解决什么问题
DeepGEMM 是 DeepSeek 专为大语言模型(特别是 DeepSeek-V3 / V2.5 / R1 等超大规模 MoE 模型)研发的开源超高性能 Tensor Core GEMM 算子库。
(1) 为什么现有开源库(CUTLASS 3.x / cuBLASLt)不够用?
- CUTLASS 3.x 极其庞大的 C++ 模板膨胀与编译噩梦:
- 传统 CUTLASS 依赖极深的模板嵌套与代数表达(Layout、Tile、Iterator、Collective Builder),仅编译一组 GEMM 内核通常需要数分钟乃至数十分钟;
- 工业级二次开发、定制特殊访存或微架构调优时,工程师深陷模板推导黑洞,调试门槛极高。
- DeepSeek-V3 细粒度分块量化( Block-wise FP8)缺乏原生极致优化(如图 13-1** 所示)**:
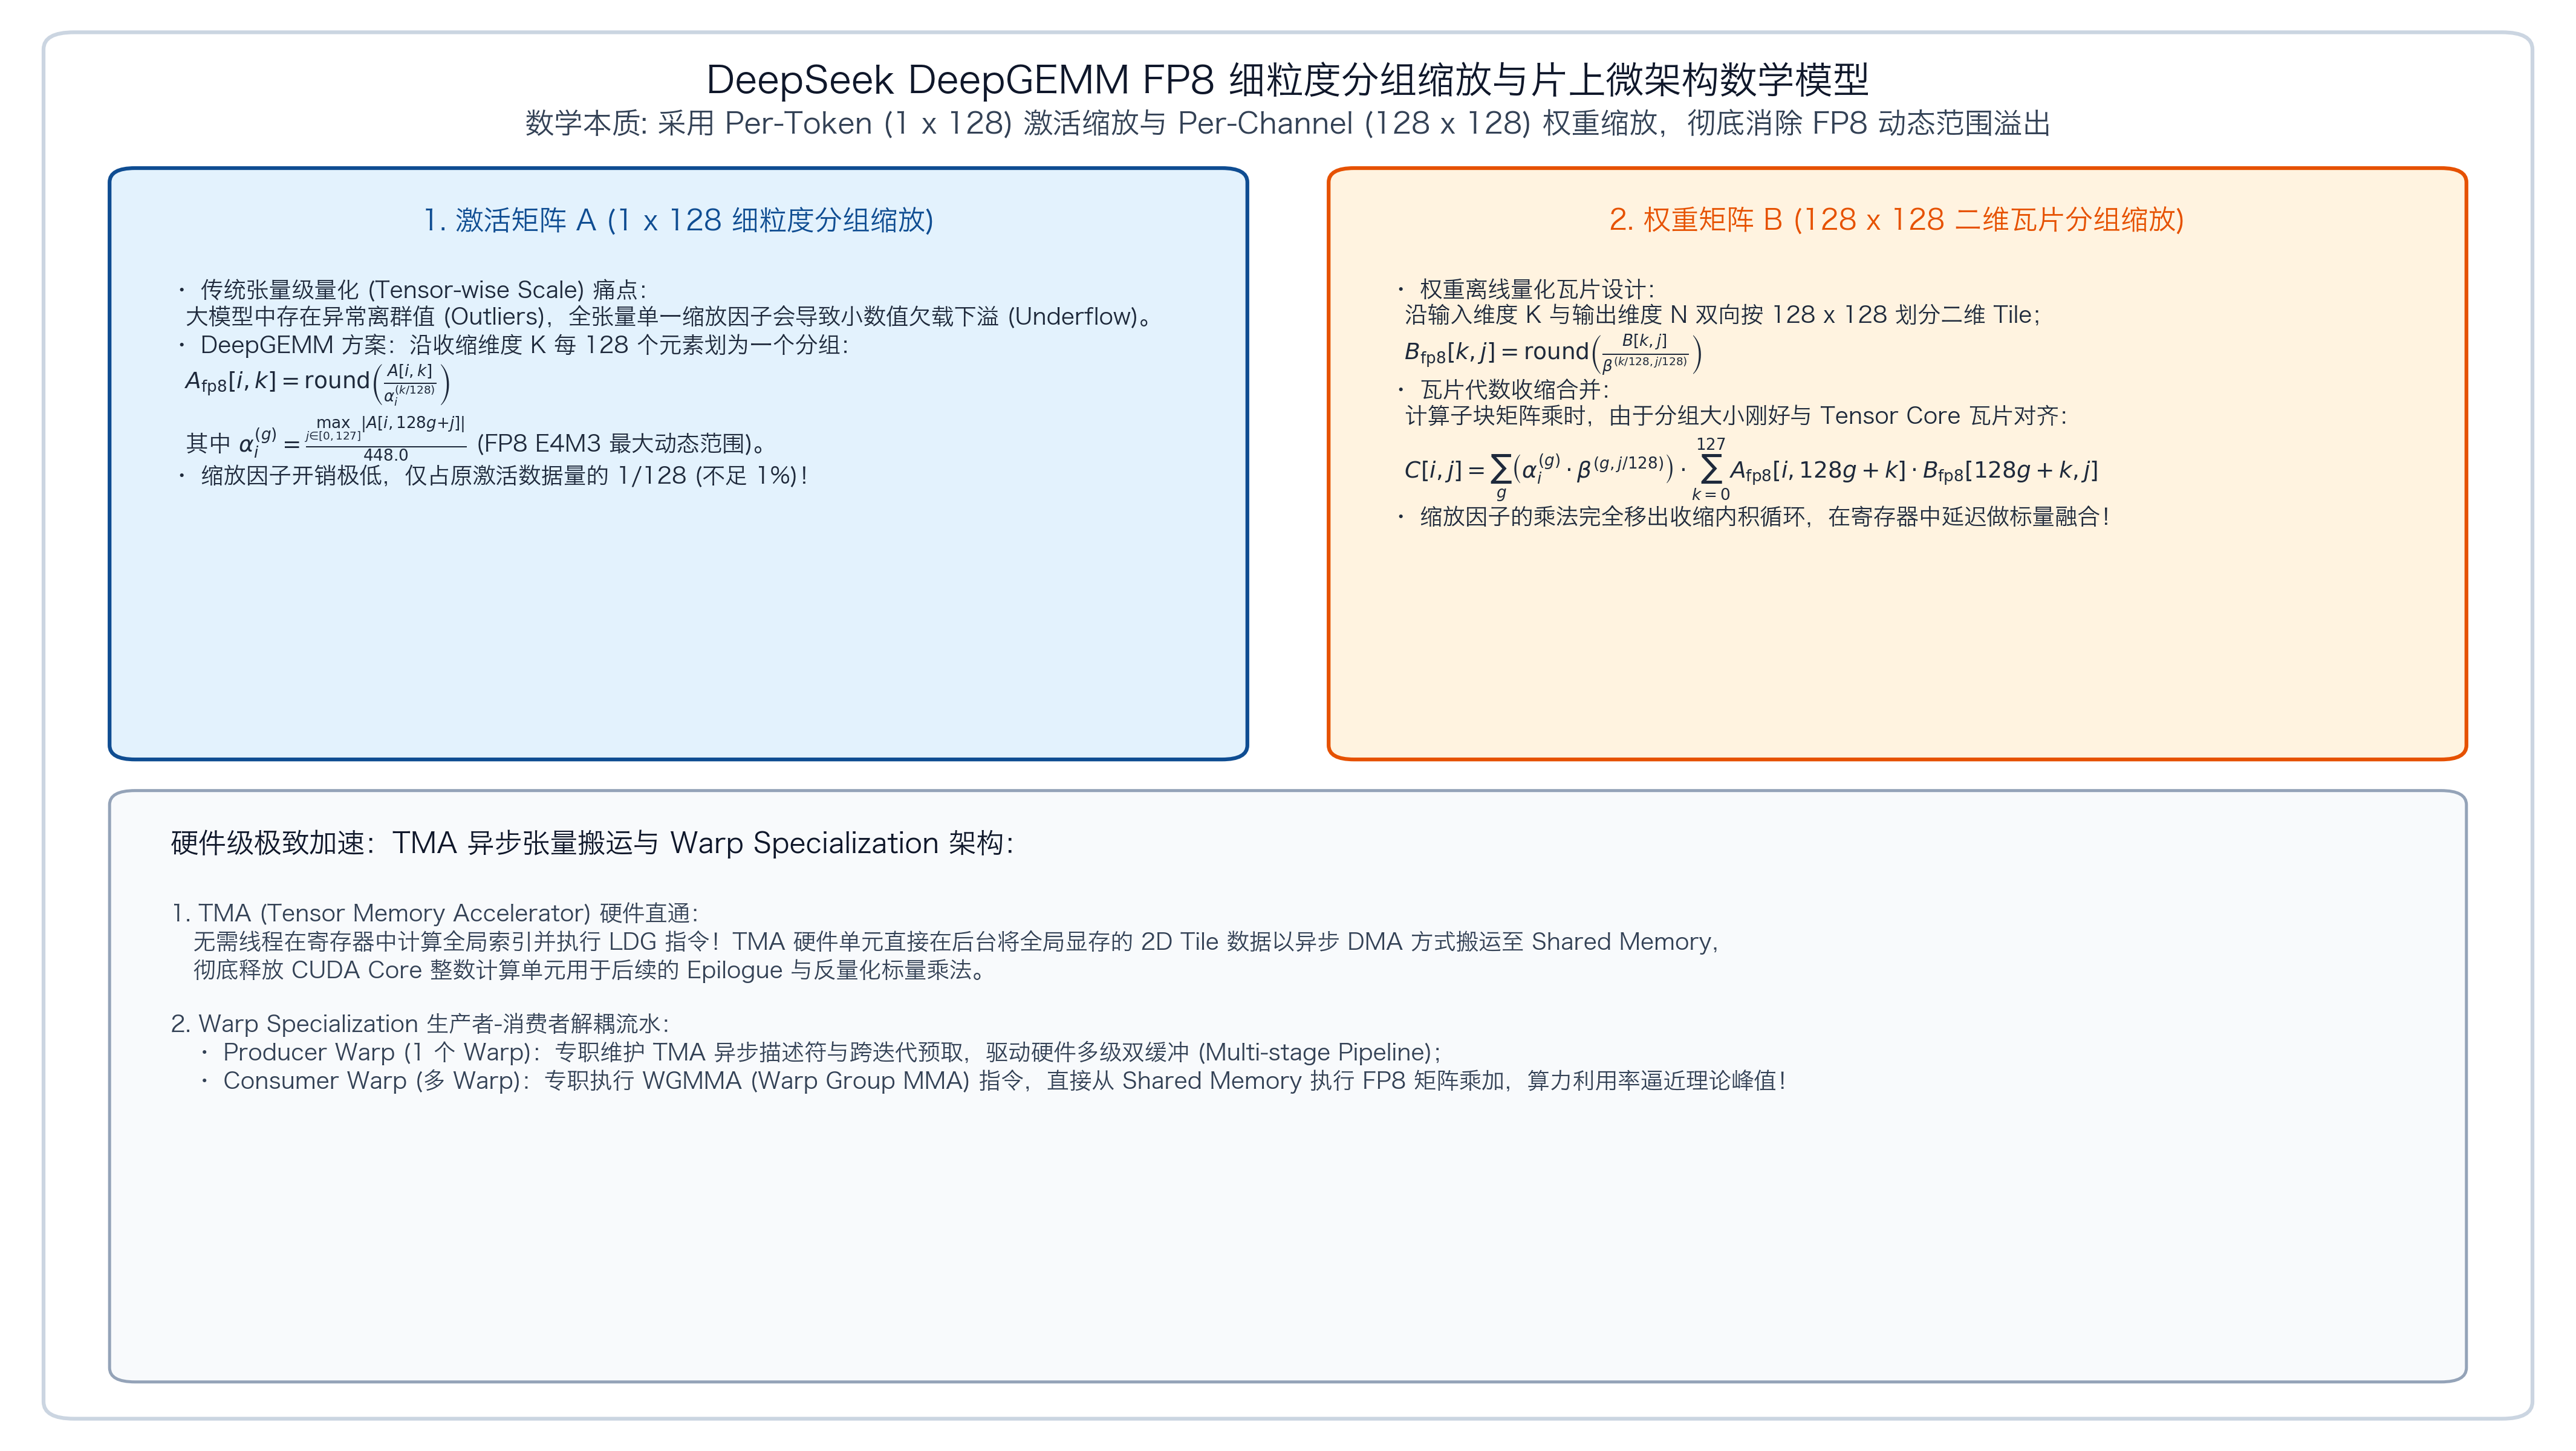
图 13-1:DeepSeek DeepGEMM FP8 细粒度分组缩放与片上微架构数学模型
- 常规 TensorRT-LLM 或 cuBLASLt 主要面向 Tensor-wise(整张量单标量缩放) 或 Channel-wise(逐通道缩放);
- DeepSeek-V3 为了在 FP8 下保持与 BF16 无损的数学精度,提出了 的 Block-wise Fine-grained Scaling:矩阵在 维度每 128 个元素划分为一个独立 Block,拥有专属的 FP32/UE8M0 缩放系数。这要求 GEMM 内核的 Epilogue 必须在极短时间内完成多维缩放反量化,cuBLASLt 无法原生内联融合。
- MoE 解码(Decoding)与 CUDA Graph 的静态分配冲突:
- 在推理 Decode 阶段,各 Expert 分配到的 Token 数量极小且每步动态变化;
- 若使用传统变长 Grouped GEMM,CPU 必须每步重新统计各专家 Token 偏移量并下发 Kernel 参数,彻底打破 CUDA Graph 捕获机制,带来沉重的 CPU Launch 延迟。
(2) DeepGEMM 的破局设计
- Radical KISS 原则:完全摒弃 CUTLASS 繁重的类层次结构,精炼出不到数千行的自包含代码,通过轻量级 C++ JIT(即时编译)模块在运行时极速加载,免去安装时的预编译开销;
- 原生拥抱 Hopper 硬件原语:深度利用 SM90 硬件级 TMA(张量内存加速器)与 WGMMA 指令,在 H800/H100 上跑出高达 1550 TFLOPS(逼近硬件理论极限的 85%~90%);
- 双模 MoE Grouped GEMM 支持(如图 13-3** 所示)**:
图 13-3:DeepGEMM 面向 MoE 的 Contiguous 与 Masked 两大布局设计对比
Contiguous:用于训练前向/反向与推理 Prefill,连续内存拼接,算力利用率最大化;Masked:用于推理 Decode,配合 DeepEP 零 CPU 开销静态捕获,以 Mask 标记有效 Token,完全兼容 CUDA Graph。
2. Hopper (SM90) 硬件微架构机制剖析(如图 13-2 所示)
flowchart TD
    subgraph HopperPipeline["DeepGEMM Hopper (SM90) 异步生产者-消费者流水线"]
        direction TB
        subgraph Producer["生产者:1 个 TMA Warp Group (128 线程)"]
            TMA_A["TMA 异步批量读取 Matrix A<br>(cp.async.bulk.tensor)"]
            TMA_B["TMA 异步批量读取 Matrix B<br>(cp.async.bulk.tensor)"]
            TMA_SF["TMA 异步加载 1x128 缩放因子 Scale Factors"]
            MBarrier_Tx["mbarrier.arrive.expect_tx<br>(向硬件事务屏障注册字节数)"]
            TMA_A & TMA_B & TMA_SF --> MBarrier_Tx
        end

        subgraph SMEM["片上共享内存 (SMEM 多级循环缓冲区: kNumStages = 3~4)"]
            Smem_A["SMem A Tile [BLOCK_M, 128] FP8"]
            Smem_B["SMem B Tile [BLOCK_N, 128] FP8"]
            Smem_SF["SMem Scale Factors FP32"]
        end

        subgraph Consumer["消费者:Math Warp Groups (128/256 线程)"]
            MBarrier_Wait["mbarrier.try_wait.parity<br>(非阻塞硬件轮询事务完成)"]
            WGMMA["wgmma.mma_async<br>(Tensor Core 直接从 SMEM 读入 A/B, 累加至 FP32 寄存器)"]
            Epilogue["细粒度反量化 Epilogue:<br>Reg D = D * SF_A * SF_B -> BF16 写回 GMEM"]
            MBarrier_Wait --> WGMMA --> Epilogue
        end

        Producer -->|硬件异步直通写入| SMEM
        SMEM -->|SS 模式零寄存器开销| Consumer
    end
图 13-2:DeepGEMM 在 Hopper 架构下的 TMA 硬件直连与 WGMMA 异步多级流水线架构
要真正看懂 DeepGEMM 的源码,必须理解 Hopper 架构相对于 Ampere 架构发生的三大革命性跃迁:
(1) TMA (Tensor Memory Accelerator):异步硬件批量搬运
- Ampere 痛点:在 Ampere(SM80)中,虽然引入了
cp.async,但每个线程仍需显式计算地址偏移,执行指令发射。 - Hopper 创新:TMA 是片上独立的专用硬件单元。线程只需配置一个
cute::TmaDescriptor(包含张量基地址、形状、跨度、分块尺寸及 Swizzle 模式),随后仅需由单个线程发起一条cp.async.bulk.tensor指令,硬件直接将多维张量瓦片从全局显存(Global Memory)搬运至共享内存(Shared Memory),全程完全不占用 SM 通用寄存器和 ALU 算力!
(2) WGMMA (wgmma.mma_async):Warp-Group 级异步矩阵乘
- Ampere 痛点:
mma.sync是 Warp 级同步指令,线程必须先从 SMEM 把数据显式ldmatrix加载到通用寄存器(Register File),消耗大量寄存器配额,极易导致寄存器溢出(Spilling)而降低 Occupancy。 - Hopper 创新:WGMMA 提升至 Warp-Group(4 个 Warp,共 128 个线程) 协同粒度。更关键的是,它支持 SS(Shared-Shared)寻址模式:Tensor Core 直接从 Shared Memory 读取矩阵 A 与矩阵 B 的切片执行点积,中间完全跳过通用寄存器!仅输出累加矩阵 保存在 FP32 寄存器中,极大节省了片上寄存器开销。
(3) 生产者-消费者解耦(Producer-Consumer Splitting)与 mbarrier
DeepGEMM 将一个 ThreadBlock(例如 256 或 384 线程)进行角色解耦:
- 生产者(TMA Warp-Group,128 线程):负责调度 TMA 硬件发起下一阶段的 A、B 及 Scale Factor 数据预取,并在硬件事务屏障(
ClusterTransactionBarrier)上注册预期传输字节数(expect_tx); - 消费者(Math Warp-Groups,128 或 256 线程):通过
mbarrier.try_wait.parity轮询硬件屏障。一旦 TMA 数据到位,立即执行wgmma.mma_async,实现极致的多级流水掩盖()。
3. DeepGEMM 核心代码架构逐行拆解
以下代码节选自 DeepGEMM 核心源码 sm90_fp8_gemm_1d1d.cuh,展现其关键骨架:
// DeepGEMM: TMA 与 WGMMA 核心主循环骨架
#pragma once
#include <deep_gemm/ptx/tma.cuh>
#include <deep_gemm/ptx/wgmma.cuh>

template <uint32_t BLOCK_M, uint32_t BLOCK_N, uint32_t BLOCK_K, uint32_t kNumStages>
__device__ void gemm_loop(
    const cute::TmaDescriptor& tensor_map_a,
    const cute::TmaDescriptor& tensor_map_b,
    float* smem_sfa, float* smem_sfb,
    uint32_t k_tiles) {

    // 1. 硬件事务屏障初始化
    extern __shared__ char smem_raw[];
    auto* barriers = reinterpret_cast<cutlass::arch::ClusterTransactionBarrier*>(smem_raw);

    // 2. 区分生产者(TMA)与消费者(Math)
    const uint32_t warp_group_idx = threadIdx.x / 128;
    const bool is_producer = (warp_group_idx == 0);

    #pragma unroll 1
    for (uint32_t k = 0; k < k_tiles; ++k) {
        uint32_t stage = k % kNumStages;

        if (is_producer && threadIdx.x == 0) {
            // 生产者主线程:设置本阶段期望接收的 TMA 字节数
            uint32_t tx_bytes = (BLOCK_M * BLOCK_K + BLOCK_N * BLOCK_K) * sizeof(__nv_fp8_e4m3);
            ptx::mbarrier_arrive_and_set_tx(&barriers[stage], tx_bytes);

            // 发起 TMA 异步多维拷贝
            ptx::tma_copy_2d(tensor_map_a, &barriers[stage], stage, k);
            ptx::tma_copy_2d(tensor_map_b, &barriers[stage], stage, k);
        }

        if (!is_producer) {
            // 消费者:等待当前 Stage 数据加载完毕(硬件屏障就绪)
            ptx::mbarrier_wait(&barriers[stage], k / kNumStages);

            // 消费者:发射 WGMMA 指令(SS 模式:直接自 SMEM 计算并累加到寄存器 D)
            wgmma::FP8MMA<BLOCK_N>::wgmma(
                desc_a[stage], desc_b[stage], accum_d, /*scale_d=*/(k != 0)
            );
        }
    }
}
实践任务:唯一代码填空题
练习说明
在不支持真实 Hopper 物理 GPU 的模拟环境或静态代码审查中,我们需要深刻理解其分块细粒度反量化逻辑与算子数值等价性。
请实现一个细粒度分块量化 GEMM 模拟器(Block-wise FP8 GEMM with 1x128 Fine-grained Dequantization):
- 输入矩阵 与矩阵 采用 FP8 E4M3 数值格式(在练习中用低精度浮点模拟);
- 维度按 元素切分成若干 Block。每个 Block 拥有一个对应的缩放因子 与 ;
- 真实数学计算:对于分块 ,子块点积结果累加后,需乘上对应的缩放标量:;
- 请补齐缺失的循环步进与反量化数学逻辑。
只能修改 TODO/______ 位置,不得删除断言或放宽通过条件。
Code
import numpy as np

def fine_grained_block_gemm_simulation(A_fp8, B_fp8, S_A, S_B, block_k=128):
    """
    模拟 DeepGEMM 的 1x128 细粒度 Block-wise FP8 GEMM 计算流
    A_fp8: [M, K]  (E4M3 量化整型或低精度模拟)
    B_fp8: [N, K]  (E4M3 量化整型或低精度模拟,注意 B 为 Transposed 存储)
    S_A:   [M, K // block_k]  (FP32 缩放因子)
    S_B:   [N, K // block_k]  (FP32 缩放因子)
    return: D [M, N] FP32 结果
    """
    M, K = A_fp8.shape
    N, K_b = B_fp8.shape
    assert K == K_b, "K dimension mismatch"
    assert K % block_k == 0, "K must be divisible by block_k"
    num_blocks = K // block_k

    D = np.zeros((M, N), dtype=np.float32)

    # 模拟 Hopper 内核外层循环:逐个 Block_K 推进并进行细粒度反量化累加
    for b in range(num_blocks):
        k_start = b * block_k
        k_end = ______

        # 提取当前 128-channel 瓦片
        A_tile = A_fp8[:, k_start:k_end]  # [M, block_k]
        B_tile = B_fp8[:, k_start:k_end]  # [N, block_k]

        # 1. 执行片上 Tile 点积累加: Tile_Acc = A_tile @ B_tile.T  -> [M, N]
        tile_acc = np.matmul(A_tile, B_tile.T)

        # 2. 提取当前 Block 的缩放因子外积: scale_tile = S_A[:, b:b+1] * S_B[:, b:b+1].T -> [M, N]
        scale_tile = ______

        # 3. 将反量化后的局部瓦片累加至全局输出矩阵 D
        D += ______

    return D

# 测试用例验证
np.random.seed(42)
M, N, K = 128, 64, 256
block_k = 128

# 构造模拟输入
A_sim = np.random.randint(-10, 10, size=(M, K)).astype(np.float32)
B_sim = np.random.randint(-10, 10, size=(N, K)).astype(np.float32)
S_A = np.random.uniform(0.01, 0.05, size=(M, K // block_k)).astype(np.float32)
S_B = np.random.uniform(0.01, 0.05, size=(N, K // block_k)).astype(np.float32)

# 正确标准数学对照
ref_D = np.zeros((M, N), dtype=np.float32)
for b in range(K // block_k):
    A_sub = A_sim[:, b*block_k : (b+1)*block_k] * S_A[:, b:b+1]
    B_sub = B_sim[:, b*block_k : (b+1)*block_k] * S_B[:, b:b+1]
    ref_D += np.matmul(A_sub, B_sub.T)

out_D = fine_grained_block_gemm_simulation(A_sim, B_sim, S_A, S_B, block_k=128)
assert np.allclose(out_D, ref_D, atol=1e-5), f"Max difference: {np.max(np.abs(out_D - ref_D))}"
print("DeepGEMM 细粒度分块量化模拟测试通过!")
检查方法
运行脚本验证断言通过;核对 num_blocks 累加与数学基准的一致性。
Q1
为什么 DeepSeek-V3 选择 的 Block-wise FP8 量化,而不是直接沿用整个 Tensor 共享一个 Scale(Tensor-wise)?这对 Hopper WGMMA 硬件执行提出了什么挑战?
你的答案:
Q2
在 Hopper 架构中,WGMMA 指令的“SS(Shared-to-Shared)”模式与 Ampere 架构下的 ldmatrix + mma.sync 相比,消除了哪些微架构开销?为什么能大幅提升寄存器利用率和算子性能?
你的答案:
Q3
在 MoE 推理的 Decoding 阶段,DeepGEMM 为什么专门设计了 m_grouped_fp8_gemm_nt_masked 算子?为什么变长 Contiguous Grouped GEMM 无法与 CUDA Graph 协同工作?
你的答案:
评分与通过规则
- 代码 4 分:正确填补
k_end、scale_tile与D累加逻辑并通过断言; - Q1~Q3 各 2 分:必须从算子精度下溢、寄存器/访存层次、CUDA Graph 静态内存模型等本质因果链回答;
- 一票否决:无法讲清 WGMMA 与 TMA 的分工,或混淆 Tensor-wise 与 Block-wise 量化。