flowchart LR
    subgraph GEMV_Mapping["Block-per-Row 映射拓扑"]
        direction TB
        M0["Matrix Row 0 (K 个元素)"] -->|"Block 0 (256 线程协同)"| Dot0["输出 y[0]"]
        M1["Matrix Row 1 (K 个元素)"] -->|"Block 1 (256 线程协同)"| Dot1["输出 y[1]"]
        M2["Matrix Row 2 (K 个元素)"] -->|"Block 2 (256 线程协同)"| Dot2["输出 y[2]"]
        X["全局向量 x (K 个元素,被所有 Block 高频复用)"] -.-> Dot0 & Dot1 & Dot2
    end
第 3 课:GEMV 与行级并行
参考答案版:包含完整代码实现与问答题深度参考解析。建议先独立完成练习题后再展开核对。
本课目标与完成标准
学完后你应能:把矩阵行映射到 block,复用 block reduce 完成点积并分析带宽瓶颈。
通过必须同时满足:
- 独立补齐本课唯一的代码填空题,并通过给定检查;
- 三个问答题均说明因果链,而不是只报术语;
- 能指出至少一个正确性边界和一个性能取舍;
- 总分不低于 8/10,且没有一票否决级概念错误。
前置关系
- 课程前置:C/C++、线性代数、基本并行编程
- 本课在路线中的作用:GEMV 每个输出是矩阵一行与向量的点积,算术强度低,通常受内存带宽限制。
核心心智模型
1. 矩阵-向量乘(GEMV)在大模型推理中的地位与算术强度瓶颈
通用矩阵-向量乘(General Matrix-Vector Multiplication, GEMV: )是线性代数与深度学习中的基础算子。 尤其在大语言模型(LLM)的自回归解码生成阶段(Decode Phase)中,每生成一个新 Token,KV Cache 投影以及 MLP 投影都是以单个 Token(即批次维度 )输入线性层。此时通用的矩阵乘(GEMM: )必然退化为矩阵-向量乘(GEMV: ):
- 极低的算术强度(Memory-Bound 典型代表,结合图 3-1 Roofline 模型):
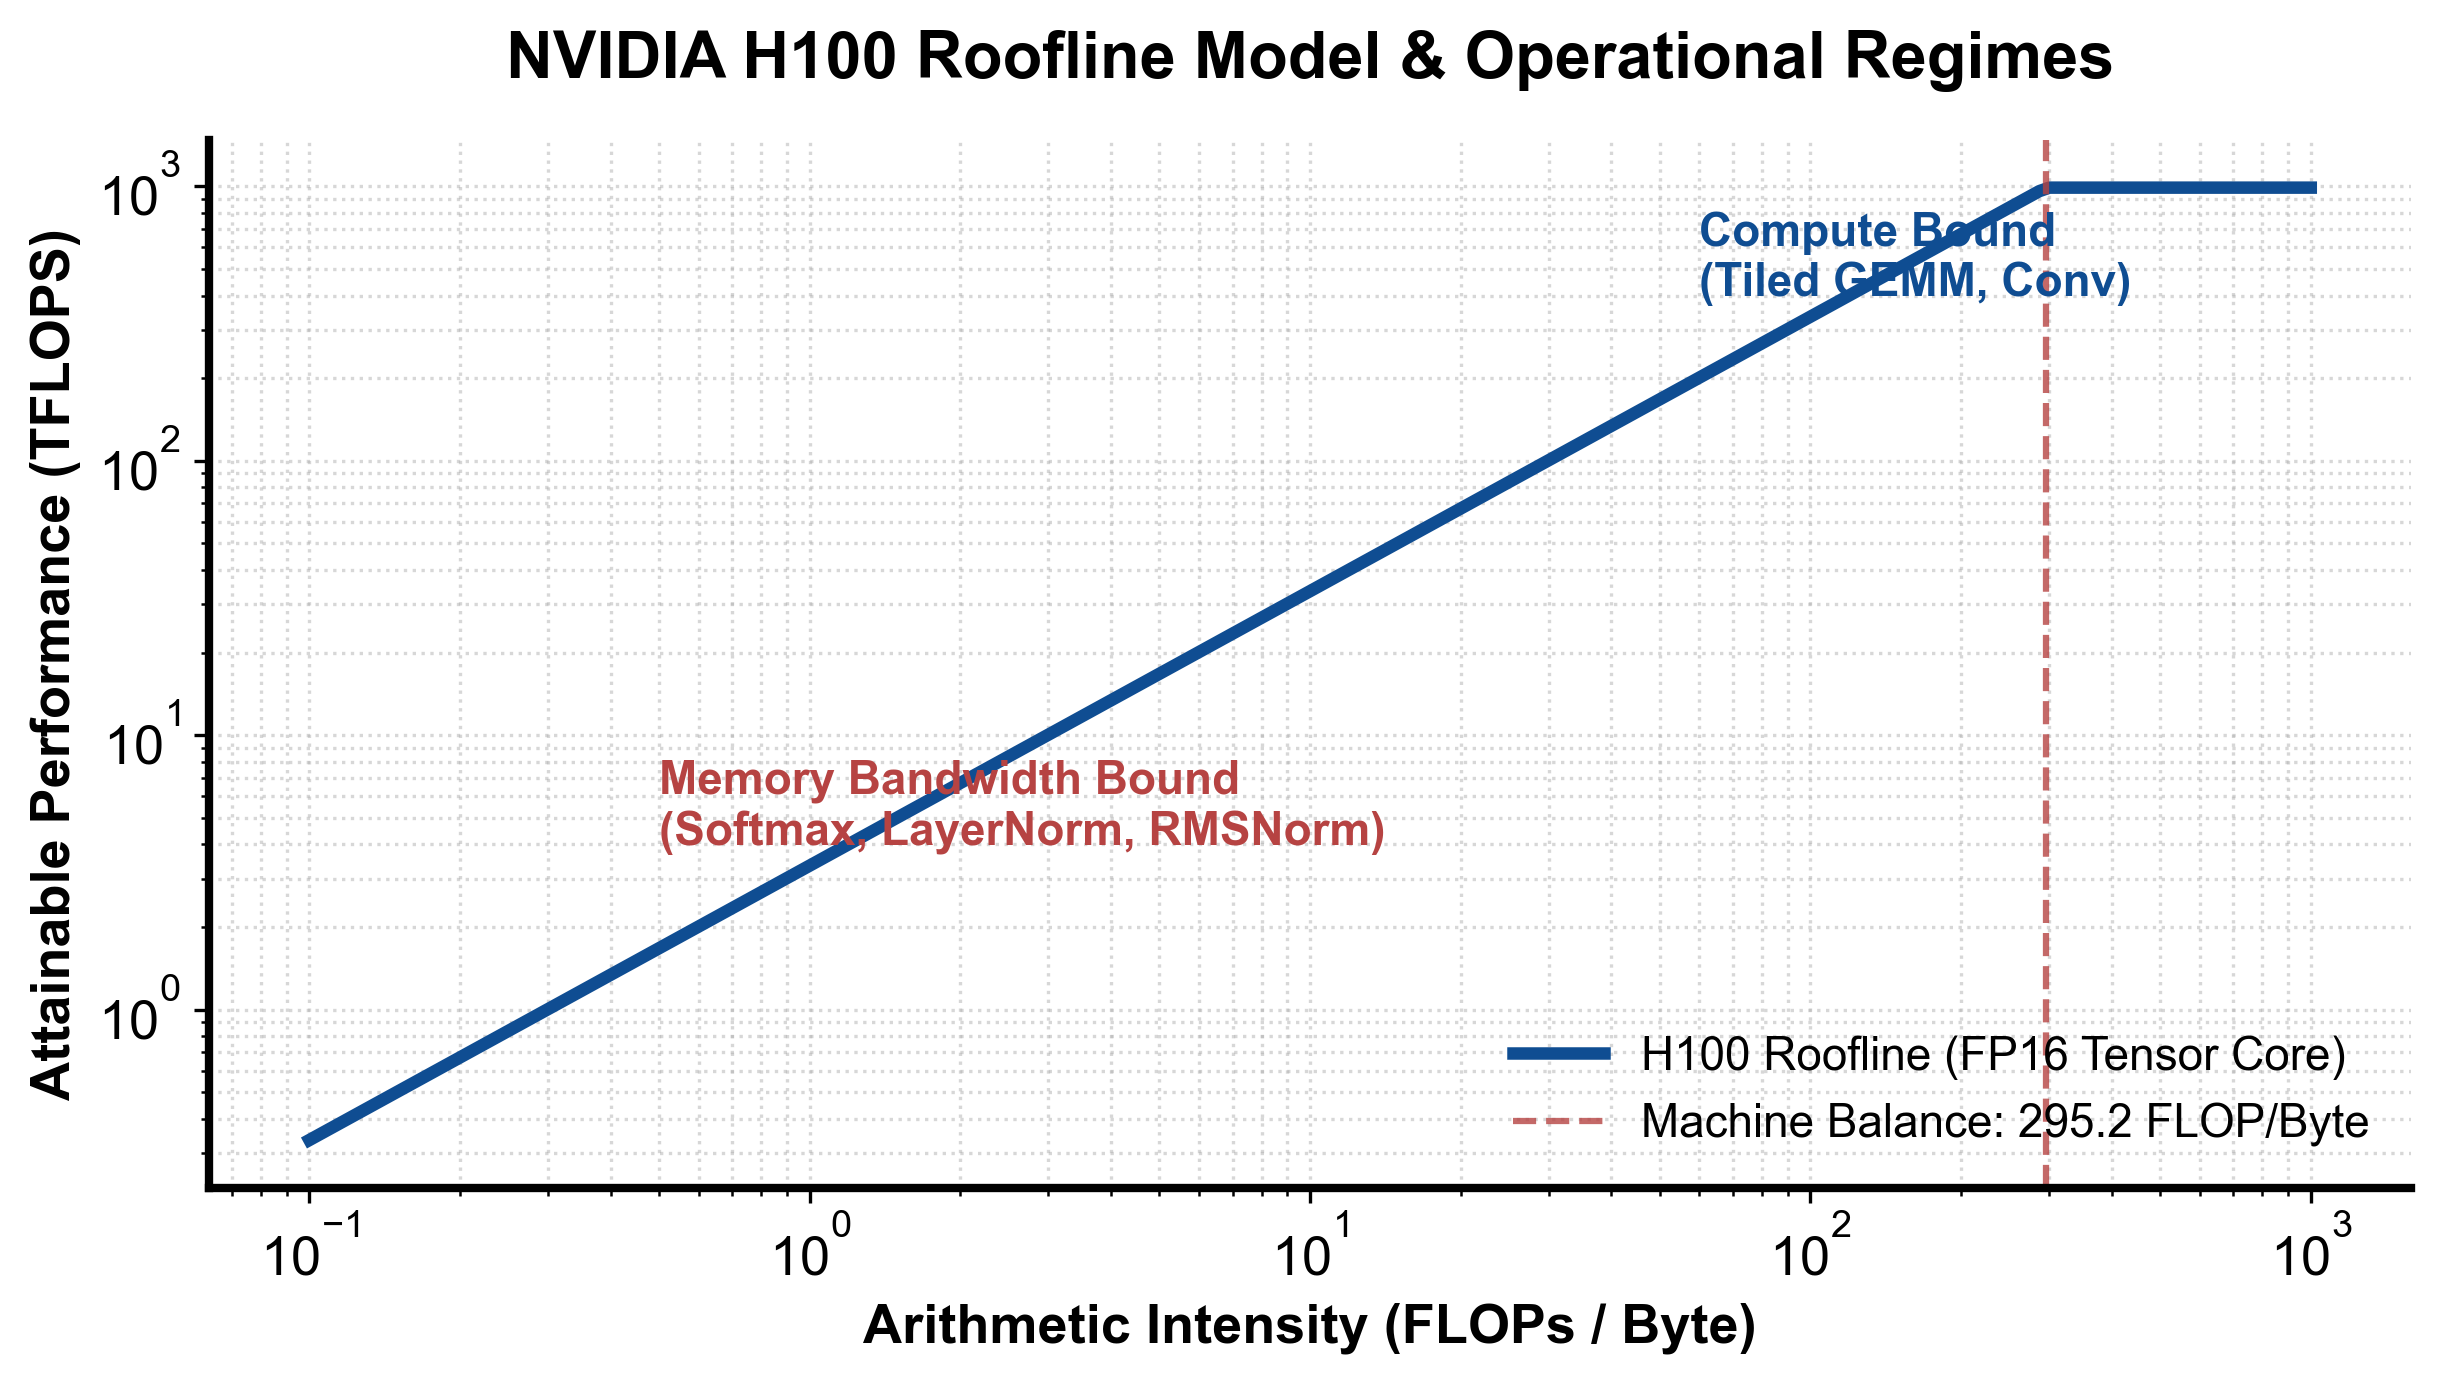
图 3-1:NVIDIA H100 Roofline 性能模型与 GEMV 极低算术强度访存受限瓶颈
设矩阵 ,向量 。 - 理论计算量:每个元素需要 1 次乘法和 1 次加法,总浮点运算量为 ; - 显存访存量:必须从全局内存中加载整个权重矩阵 ( 字节),读取向量 ( 字节),并写回结果 ( 字节)。 - 其算术强度上限仅为: 在标称带宽 的 H100 GPU 上,GEMV 的理论算力上限只有 (远低于硬件 峰值)。 因此,GEMV 的优化哲学在于:极致榨干全局显存读取带宽,确保权重矩阵 的合并访存,并最大化向量 在 L1/L2 缓存中的数据复用。
2. 行级并行与 Block 映射架构(如图 3-1 至图 3-3 所示)
在行优先(Row-Major)存储格式下,矩阵 的同一行元素在物理内存地址中是严格连续排列的。
A. 为什么必须采用“一个 Block 负责一行(Block-per-Row)”?
如果在初学者代码中采用朴素的“一个线程负责一行(Thread-per-Row)”:
- 线程 0 计算第 0 行,线程 1 计算第 1 行……
- 同一个 Warp 内的 32 个线程在同一时刻读取各自行的第 0 列元素:
A[0, 0], A[1, 0], A[2, 0], ...; - 由于是行优先存储,相邻两个元素的内存地址相隔整整 字节!
- 访存灾难:32 个线程的访存完全离散,硬件无法执行合并访存,被迫拆分为 32 次独立的内存事务,总线有效利用率暴跌至不足 5%!
工业级标准设计采用如图 3-2 所示的 Block-per-Row(一个线程块负责一行矩阵-向量点积):
图 3-2:GEMV 矩阵-向量乘行级映射与数据复用拓扑
每个 Thread Block(例如
BLOCK_SIZE = 256)专职负责输出向量的一个分量 ,即计算第row = blockIdx.x行与向量 的内积。Block 内的 256 个线程沿着列维度以网格跨步循环前移:
for (int col = tid; col < N; col += BLOCK_SIZE) { local_sum += row_A[col] * x[col]; }完美访存合并:Warp 内的线程 0 至 31 访问的地址是
row_A[0], row_A[1], ..., row_A[31],在物理内存上完全连续且天然 128 字节对齐!
B. 向量 的高速片上缓存复用
在计算过程中,所有的 Block(共 个)都需要与同一个向量 相乘。 虽然每个 Block 都从显存中逻辑读取 ,但由于硬件 L1 Data Cache 和 L2 Cache(几十 MB)的巨大容量,向量 在首个 Block 读取后便大概率常驻在高速片上缓存中,后续各个 Block 读取 几乎全部命中 L2 缓存,极大缓解了显存带宽压力。
C. 点积规约与原子写入解耦(图 3-3)
sequenceDiagram
    autonumber
    participant T as Block 内部线程 (256 线程)
    participant V as float4 向量化加载
    participant W as Warp 洗牌规约
    participant GM as 全局内存 y[row]

    T->>V: 跨步网格循环连续加载 A[row, k..k+3] 与 x[k..k+3]
    V->>T: 片上寄存器积和累加 sum += a * x
    T->>W: Warp 内 __shfl_down_sync 折半求和
    W->>GM: 线程 0 将最终标量直接写入 y[row]
图 3-3:GEMV 单行点积累加与 Warp 归约执行流水
当 Block 内每个线程完成各自负责列的局部乘累加后,调用第 2 课所学的 block_reduce_sum:
Warp 内通过
__shfl_down_sync快速树状折叠;跨 Warp 通过 Shared Memory 汇聚为单一标量
sum;仅由
tid == 0的单线程将偏置bias[row]加上,直接写回全局内存y[row]。全程无任何原子操作(Atomic-Free),消除了内存争用。
3. 正确性边界与指针安全性
- 偏置指针解引用保护:
- 线性层并非全部带有偏置项(例如现代 LLaMA 架构完全移除了偏置)。
- 内核代码必须支持
bias == nullptr的情况:y[row] = sum + (bias ? bias[row] : 0.0f);,严禁无防护直接解引用空指针。
- 矩阵维度跨步安全:
- 当矩阵的行数 大于启动的 Block 数量时,必须依赖网格跨步或确保启动网格充足;
- 越界检查
if (row >= M) return;必须放在进入行指针计算的最前端。
4. 性能与工程权舍:何时从 GEMV 转向 GEMM?
- Block 大小的平衡点:
- 若列数 较小(例如 ),分配 256 线程会导致一半的线程闲置;
- 工业级高性能库(如 cuBLAS)会根据 的大小动态调整:当 时采用 Warp-per-Row(一个 Warp 负责一行),当 时采用 Block-per-Row。
- 转入 GEMM 的临界点(Prefill vs Decode):
- 当并发请求增多,或者进入长 Prompt 预填充阶段(Prefill Phase)时,批次或序列维度 。
- 矩阵计算变为 。其算术强度随着 线性提升:。
- 此时内核从访存瓶颈蜕变为算力密集型,必须立即切换为 Tensor Core 驱动的 GEMM 内核(如 CUTLASS / cuBLAS)。
具体演示与数值推演
设矩阵 维度为 行、 列,配置 BLOCK_SIZE = 256,启动发射网格为 <<<3, 256>>>:
- 硬件映射布局:
- 系统启动 3 个 Thread Block(Block 0, 1, 2 分别绑定处理 Row 0, 1, 2)。
- 每个 Block 内驻留 256 个线程(分为 8 个 Warp)。
- 执行推演(以 Block 0 计算 Row 0 为例):
- 单行包含 1024 个列元素,Block 内 256 个线程只需执行 轮循环;
- 第 1 轮(
col = 0 ... 255):256 个线程合并读取 与 ,在寄存器中计算乘积并累加; - 第 2~4 轮:线程每次列索引递增 256,继续以连续事务吞吐剩余元素;
- 4 轮循环结束后,每个线程的私有寄存器
local_sum中均存有 4 个元素的局部点积和; - 调用
block_reduce_sum进行 256 选 1 的快速折叠,耗时仅几十纳秒; threadIdx.x == 0线程加上bias[0],单次写回y[0]。
- 全流程收益:矩阵 的读取 100% 达成 128 字节对齐合并访存,3 行独立输出并行落地。
实践任务:唯一代码填空题
补齐局部点积更新。
规则:只能修改 TODO/______ 所在位置;不要删除断言或放宽误差。代码注释说明了每个边界条件。
Code
%%writefile /tmp/03_gemv.cu
#include <cuda_runtime.h>

namespace {

// GEMV 的核心是 dot product,因此 reduce 是主要优化点。
template<int BLOCK_SIZE>
__device__ __forceinline__ float warp_reduce_sum(float val) {
    #pragma unroll
    for (int offset = 16; offset > 0; offset >>= 1) {
        val += __shfl_down_sync(0xffffffff, val, offset);
    }
    return val;
}

// 把一个 block 内所有线程的局部 dot partial sum 合并成一个 sum。
template<int BLOCK_SIZE>
__device__ __forceinline__ float block_reduce_sum(float val) {
    constexpr int NUM_WARPS = (BLOCK_SIZE + 31) / 32;
    __shared__ float smem[NUM_WARPS];

    int lane = threadIdx.x & 31;  //等价于 threadIdx.x % 32
    int warp = threadIdx.x >> 5;  //等价于 threadIdx.x / 32

    val = warp_reduce_sum<BLOCK_SIZE>(val);

    if (lane == 0) {
        smem[warp] = val;
    }
    __syncthreads();

    val = (threadIdx.x < NUM_WARPS) ? smem[lane] : 0.0f;
    if (warp == 0) {
        val = warp_reduce_sum<BLOCK_SIZE>(val);
    }

    __syncthreads();
    return val;
}

// GEMV: y = A * x + bias
// A: [M, N] row-major
// x: [N]
// y/bias: [M]
//
// 简化优化版本:
// 一个 block 负责 A 的一行,block 内线程并行做 dot product。
// 这适合面试讲清楚线程映射、coalesced load、block reduce。
//
// 局限:
// x 会被每一行重复读取。更进一步的优化可以把 x 分块缓存到 shared memory,
// 或者多个 row/block 复用 x tile,但代码会复杂很多。
template<int BLOCK_SIZE>
__global__ void gemv_kernel(
    const float* __restrict__ A,
    const float* __restrict__ x,
    const float* __restrict__ bias,
    float* __restrict__ y,
    int M,
    int N
) {
    int row = blockIdx.x;
    int tid = threadIdx.x;
    if (row >= M) return;

    const float* row_A = A + row * N;
    float local_sum = 0.0f;

    // 每个线程负责这一行里的若干列。
    // A[row, col] 是连续地址,因此一个 warp 同一轮读 A 时是合并访存。
    // x[col] 也是连续读取,但不同 row 会重复读同一个 x。
    for (int col = tid; col < N; col += BLOCK_SIZE) {
        local_sum += ______;  // TODO: 当前列的乘积
    }

    float sum = block_reduce_sum<BLOCK_SIZE>(local_sum);

    // reduce 完后,只有一个线程写 y[row],避免写冲突。
    if (tid == 0) {
        y[row] = sum + (bias ? bias[row] : 0.0f);
    }
}

} // namespace

void launch_gemv(
    const float* A,
    const float* x,
    const float* bias,
    float* y,
    int M,
    int N,
    cudaStream_t stream
) {
    constexpr int BLOCK_SIZE = 256;
    gemv_kernel<BLOCK_SIZE><<<M, BLOCK_SIZE, 0, stream>>>(
        A, x, bias, y, M, N
    );
}
检查方法
有 CUDA 环境时执行 nvcc -std=c++17 -c /tmp/03_gemv.cu -o /tmp/03_gemv.cu.o;无 CUDA 环境时只做静态审查并登记待验证。
提交时请给出:补齐后的代码、实际运行输出(环境不可用时注明“仅静态审查”)以及对失败用例的解释。
Q1
不要背定义:请从输入、状态变化和输出三个阶段解释“GEMV 与行级并行”的工作机制。
你的答案:
Q2
把一个 thread 映射一整行与一个 block 映射一行相比,瓶颈有何不同?
你的答案:
Q3
当 batch 中矩阵数量增加时,何时应转向 GEMM?
你的答案:
评分与通过规则
- 代码 4 分:正常输入 2 分,边界输入 1 分,解释实现 1 分;
- Q1~Q3 各 2 分;
- 一票否决:结果碰巧正确但核心因果链错误、删除边界检查、把未运行结果说成实测。
需要提示时按四级机制请求:概念区域 → 具体方向 → 关键局部 → 完整答案。