sequenceDiagram
    autonumber
    participant S0 as Stage 0 (输入端)
    participant S1 as Stage 1 (中间层)
    participant S2 as Stage 2 (输出端 / Loss)

    Note over S0,S2: 预热阶段 (Warmup: S0 连续发射前向微批次填充管道)
    S0->>S1: F1 前向激活传输
    S1->>S2: F1 前向激活传输
    S0->>S1: F2 前向激活传输
    S2->>S2: 计算 Loss 并执行反向 B1
    S2-->>S1: B1 反向梯度回传

    Note over S0,S2: 1F1B 稳态阶段 (Steady State: 算一个 F 紧跟一个 B,显存进出守恒)
    S1->>S2: F2 前向激活传输
    S1-->>S0: B1 反向梯度回传 (S0 释放 F1 激活)
    S0->>S1: F3 前向激活传输 (S0 申请 F3 激活,常驻峰值恒为 p 份)
    S2->>S2: 执行反向 B2
    S2-->>S1: B2 反向梯度回传 (S2 释放 F2 激活)

    Note over S0,S2: 收尾降温阶段 (Cooldown: 连续消化剩余反向微批次)
    S1-->>S0: B2 反向梯度回传
    S1-->>S0: B3 反向梯度回传
    Note over S0,S2: 梯度累积结束,显存池激活全部清空归零
第 9 课:流水线并行 PP
参考答案版:包含完整代码实现与问答题深度参考解析。建议先独立完成练习题后再展开核对。
Important统一完成标准与及格线
代码 4 分、Q1~Q3 各 2 分,通过线 8/10。必须解释正确性边界、显存/通信公式中的单位与分片维度;未实际运行的内容只能标记为静态审查。
- 对应官方章节:Pipeline Parallelism(AFAB、1F1B、Interleaving、Zero bubble & DualPipe)
- 前置:第 2 课(激活)、第 3 课(P2P 通信)、第 5 课(与 ZeRO-3 的对比)
- 状态:未开始
本课目标
完成后你需要能够:
- 推导 naive / AFAB / 1F1B / interleaved 四种调度的 bubble 公式。
- 解释为什么 AFAB 有激活爆炸、1F1B 没有(内存从 m 降到 p 个微批次)。
- 说明 interleaved 的通信代价(×v)与 depth-first / breadth-first 调度选择。
- 解释 zero bubble(B/W 拆分)与 DualPipe(双向双流)的核心思想。
- 对比 PP 与 ZeRO-3,说明各自适合的场景。
核心概念
1. 流水线并行(PP)的核心本质与通信优势
流水线并行(Pipeline Parallelism, PP)是超大规模深度学习训练中历史悠久且极为高效的模型并行范式。 与张量并行(TP,在单个网络层内部切分矩阵)和数据并行/ZeRO(在样本 Batch 维度切分)截然不同,PP 沿着模型的“深度方向(层数维度)”进行网络切分:
- 设模型共有 个 Transformer Block,流水线并行度为 。整个模型被切分为 个连续的 Stage(阶段),分配给 张独立的 GPU(或节点),每个 Stage 仅常驻持有 层模型权重。
- 点对点低带宽通信(P2P Communication):
- 数据的流转仅发生在相邻 Stage 之间(从 Stage 到 Stage )。
- 在前向传播中,Stage 仅需将其最后一层的输出激活值 发送给 Stage ;反向传播中,Stage 仅需将输入梯度反向传递给 Stage 。
- 关键优势:通信仅发生在 Stage 边界,通信频次极低(每微批次仅 1 次 P2P 发送与接收)。相比 TP 动辄在单层内部发起 2 次跨卡阻塞式 AllReduce,PP 对网络带宽的要求大幅降低十余倍。因此,流水线并行是跨物理节点(Cross-Node)进行模型切分扩展的首选利器。
2. 流水线气泡(Pipeline Bubble)的严格数学推导
尽管 PP 解决了机间通信带宽问题,但串行层级依赖带来了全新的系统挑战——流水线气泡(Pipeline Bubble)。 在最原始的流水线中,由于前一层未算完时后一层无事可做,各 Stage 存在漫长的空转等待。
为了压制气泡,工程上将一个全局批次进一步切分为 个微批次(Micro-Batches, MBS)。 设单个微批次的前向计算时间为 ,反向计算时间为 :
无等待的理想执行总时长: 若所有 GPU 的 Tensor Core 处于 100% 满载无空闲,总有效计算耗时为:
气泡空闲时长的几何推导:
- 预热气泡(Warmup Bubble):在流水线启动初期,Stage 0 正在计算第 1 个微批次的前向时,后续的 Stage 1 至 Stage 处于空闲状态。首个微批次传至 Stage 总共需要消耗 的空闲等待时间。
- 清空降温气泡(Cooldown Bubble):在流水线收尾阶段,当最后一个微批次的反向梯度从 Stage 逐步回传给 Stage 0 时,较深层次的 Stage 陆续结束计算进入空闲,累计产生 的空转等待。
- 总空闲气泡时长:
气泡率计算(Bubble Ratio):
- 气泡相对理想计算时间的比率为:
- 气泡占整步墙钟时间(Wall-Clock Time)的实际比例为:
如图 9-1 所示,气泡率完全由“流水线级数 ”与“微批次数 ”的比值决定。只要将微批次切得足够细(例如 乃至 ),气泡占比就会迅速被稀释到 10% 以下。
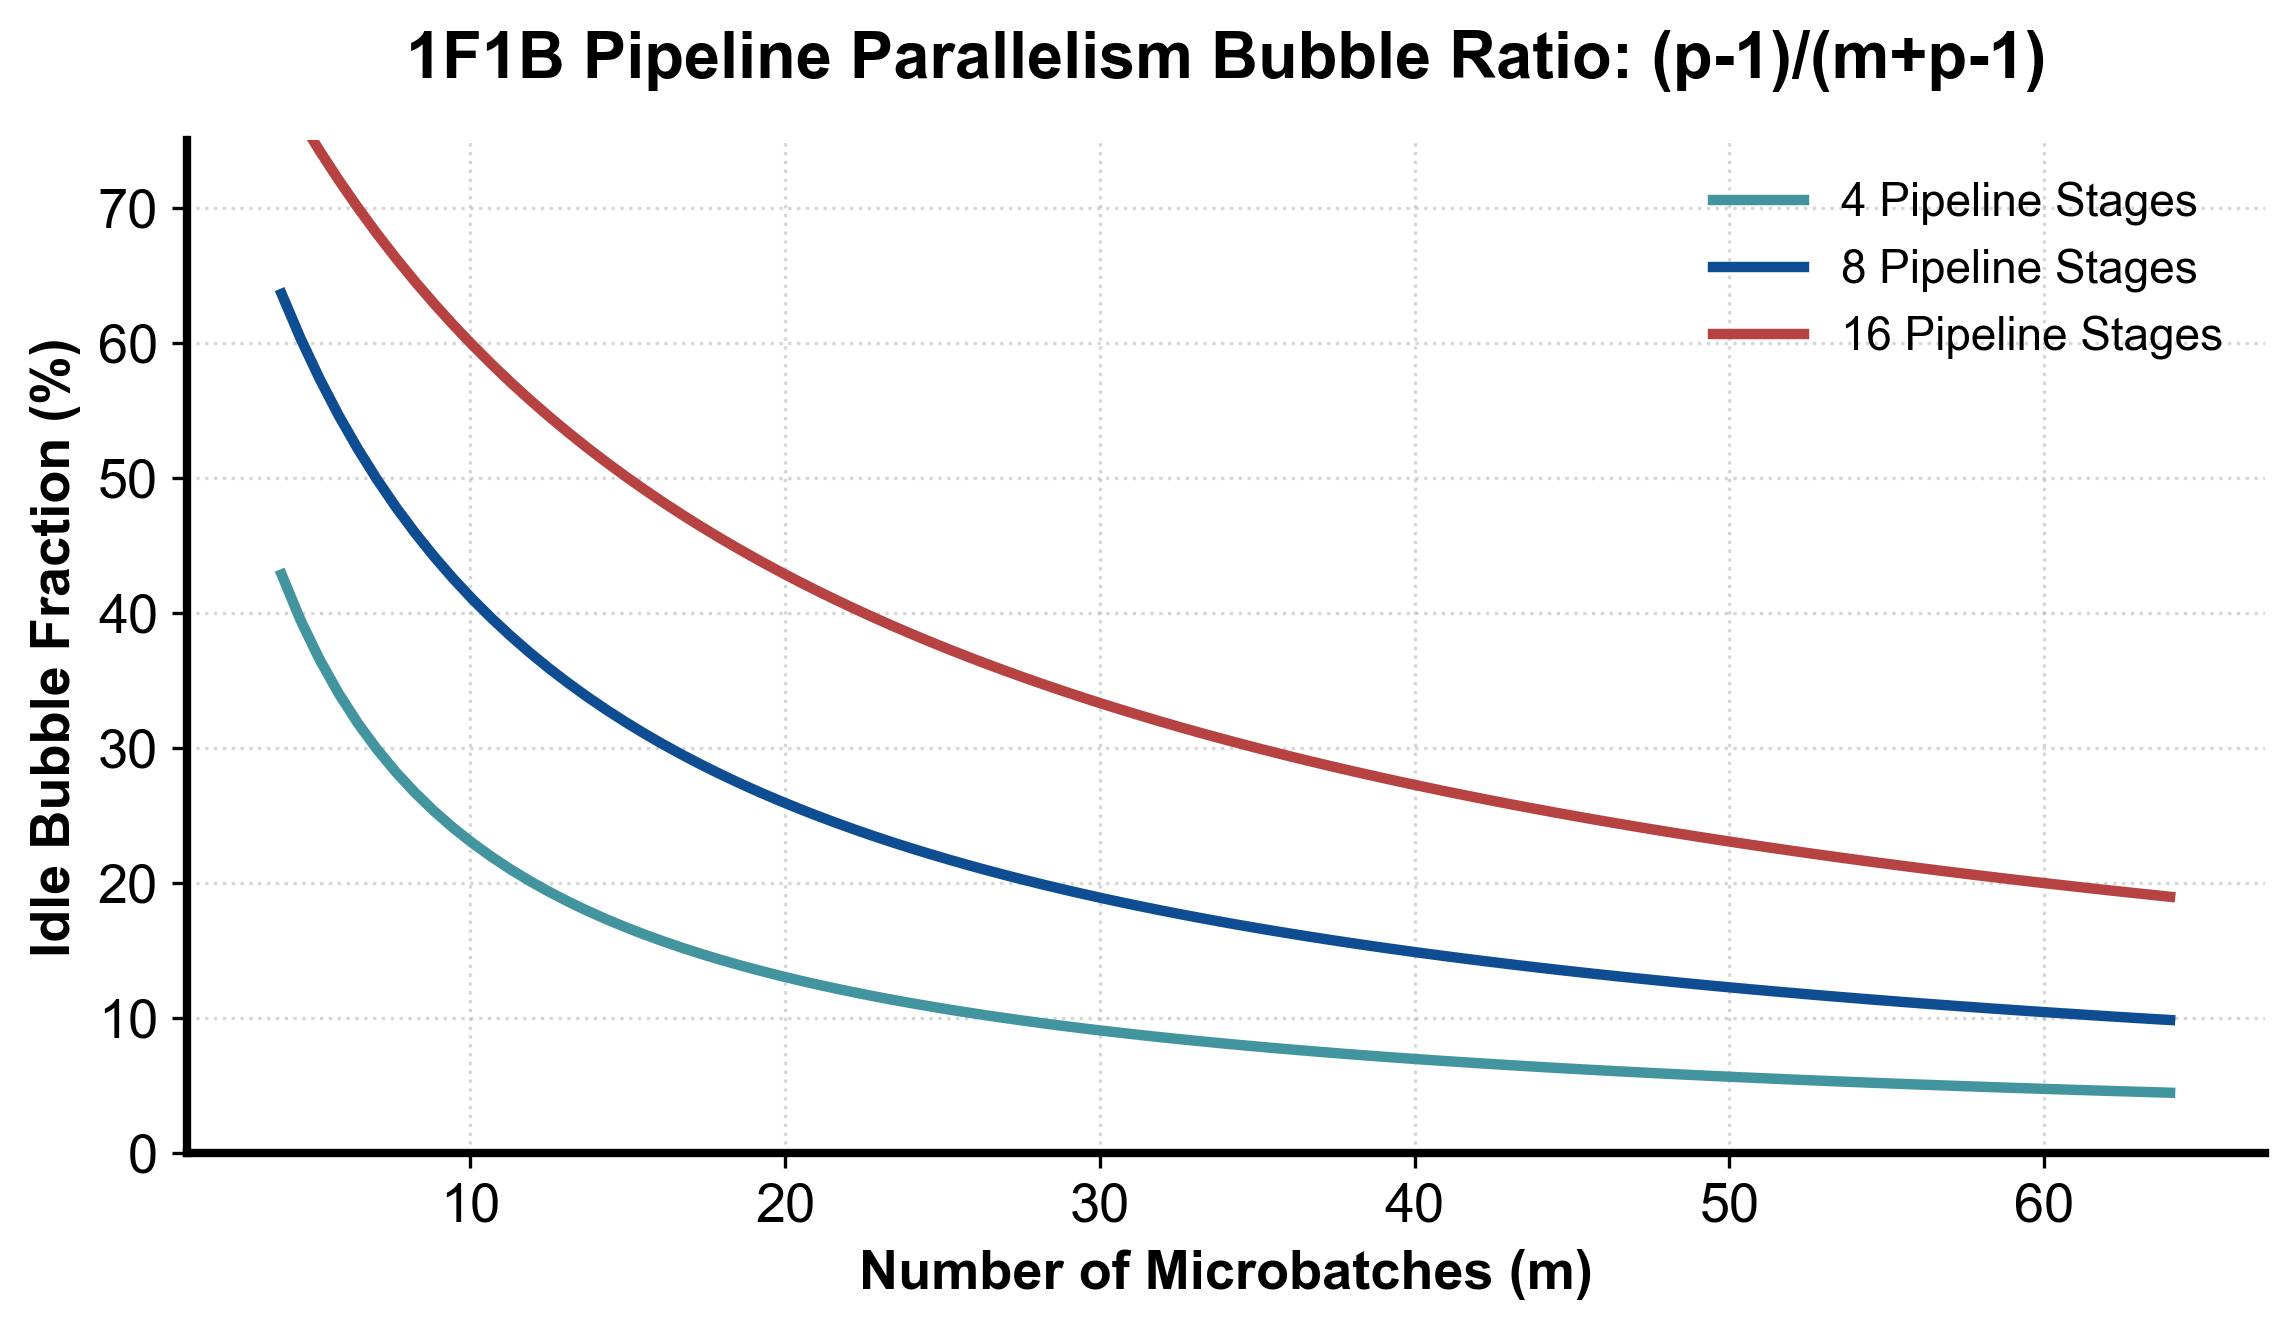
图 9-1:1F1B 流水线并行空闲气泡(Bubble)占比与 Microbatch 关系曲线
3. AFAB(All-Forward-All-Backward)调度的显存爆炸缺陷
在早期的 GPipe 调度中,采用的是 AFAB(先执行完全部前向,再执行完全部反向) 策略:
- 执行逻辑:Stage 0 连续发射 个微批次的前向计算();当所有前向数据流过流水线末端后,再倒序执行所有微批次的反向求导()。
- 致命缺陷:激活显存失控:
- 反向传播求导必须依赖前向时保存的中间激活值。
- 在 AFAB 下,第 1 个微批次 产生的激活值,必须一直保留在 GPU 显存中,直到所有 个前向全部算完、并且开始执行 时才能被释放!
- 这导致每个 GPU 必须同时在显存中驻留全部 个微批次的中间激活!
- 悖论爆发:为了减小气泡率,工程师希望将 设得尽可能大;然而 越大,单卡显存中的激活积累就呈线性暴增,导致系统迅速遭遇 OOM 崩溃。AFAB 使得 PP 丧失了节省显存的意义。
4. 1F1B 调度(One-Forward-One-Backward):显存收敛机制
为了斩断 对激活显存的绑架,Megatron-LM 提出了划时代的 1F1B 稳态调度算法。
如图 9-2 所示,1F1B 将每个 Stage 的生命周期清晰解耦为三个阶段:
图 9-2:流水线并行 1F1B 调度器跨阶段微批次流转与显存动态守恒时序图
- 预热阶段(Warmup):
- 处于 Stage 的 GPU 首先连续执行若干个前向微批次,以确保流水线通道被数据填满。
- 随着 Stage 深度递增,预热步数逐渐递减(Stage 预热 步)。
- 稳态阶段(Steady State, 1F1B):
- 核心设计:GPU 每执行一个新微批次的前向计算(),紧接着就必须执行一个最早就绪微批次的反向求导()。
- 显存出入守恒: 产生了一份新的微批次激活,但紧随其后的 立即彻底消费并销毁了一份旧的微批次激活!
- 显存池中的活跃微批次数在整个稳态期间恒定维持在 份,绝不随微批次总数 的增加而上涨!
- 清空降温阶段(Cooldown):
- 当所有前向微批次发射完毕后,GPU 连续计算剩余的反向求导,将显存中的剩余激活全部释放归零。
核心结论:1F1B 将单卡驻留激活峰值从 强力截断至 。工程师可以无所顾忌地增大微批次数 (例如 ),在将气泡率稀释到极限的同时,显存依然如坚若磐石般保持稳定。
5. Interleaved 1F1B:交错分片进一步压制气泡
如果模型参数极大,必须使用较大的流水线深度 (例如 ),则即使 ,1F1B 的气泡率仍有 。 Interleaved 1F1B(交错分片) 通过虚拟 Stage(Virtual Stages)进一步削减气泡: - 设交错因子为 (例如 )。每张物理 GPU 不再只负责一段连续的模型层,而是交错持有 个虚阶段。例如 4 张物理卡持有 8 个模型块:GPU 0 负责 Chunk 0 与 Chunk 4,GPU 1 负责 Chunk 1 与 Chunk 5…… - 微批次在物理卡环之间流动 圈。每个子块的计算粒度缩小为原来的 。 - 气泡率倍数下降:
- 代价权衡:微批次在物理设备边界之间来回穿梭的次数增加了 倍,点对点通信总量相应扩大至 倍。要求机间网络具备足够高的带宽支持。
6. 前沿调度革新:Zero-Bubble (ZB) 与 DualPipe(DeepSeek-V3 核心)
近年来大模型研发的最顶尖突破集中在消除最后 5%~10% 的流水线气泡:
A. 梯度计算拆分(B/W Separation)与 Zero-Bubble (ZB)
传统调度将反向传播视为一个不可分割的整体算子 。但现代编译原理揭示反向传播在底层严格包含两个无数据依赖的独立矩阵乘:
算子(Activation Gradient,激活梯度):计算 。它必须严格按反向顺序立即传给上一层 Stage,位于流水线关键路径上。
算子(Weight Gradient,权重梯度):计算 。它仅用于在 Step 末尾更新本地权重,对后续各层前向/反向的数据流向毫无依赖!
- Zero-Bubble 调度思想:将 的计算从反向关键路径上完全剥离,将其作为“填充物”延迟调度插进 Warmup 和 Cooldown 期间原本彻底闲置的气泡时间槽中,使硬件利用率逼近理论极限(Bubble )。
B. DualPipe 双向双流调度(DeepSeek-V3)
DeepSeek-V3 在极低通信预算下实现了超大规模流水线并行,其核心正是 DualPipe:
- 在物理流水线两端同时注入两个相反方向的微批次数据流(正向流从 Stage 0 向右推,反向流从 Stage 向左推)。
- 巧妙将 Forward、Backward 、Backward 以及跨机通信交织排布,用相反方向计算互相填补对方的气泡,最终在万卡集群上实现了“近乎零气泡与零显存额外膨胀”的工程奇迹。
7. 技术选型终极对决:PP vs ZeRO-3
| 决策维度 | 流水线并行 (PP) | ZeRO-3 / FSDP |
|---|---|---|
| 切分对象 | 模型的层深度(每卡持有完整层) | 每一层的参数张量(每卡持有切片) |
| 网络通信内容 | 边界处的中间激活值 | 算子执行前后的模型参数 与梯度 |
| 网络总线偏好 | 跨机低带宽网络友好(InfiniBand / RoCE) | 强依赖机内高带宽网络(跨机易受 Ring Latency 惩罚) |
| 核心性能瓶颈 | 调度气泡(Bubble Ratio ) | 参数预取重叠失败(Prefetch Exposure) |
| 超长序列适应度 | 激活随 膨胀,长序列下单卡激活显存压力大 | 激活全量驻留,需结合 TP/CP/重计算 |
| 主流业界搭配 | PP + TP + ZeRO-1 (如 DeepSeek-V3, Megatron) | 纯 FSDP / FSDP + TP (中等规模集群首选) |
具体演示与数值推演
以一个典型流水线并行配置为例:流水线级数 ,全局批次切分为 个微批次,单步反向计算时间约为前向的两倍():
朴素无流水调度(Naive Sequential): 若不进行微批次划分(),总耗时为 。有效计算仅为 ,气泡时间高达 ,算力有效率仅 。
标准 1F1B 调度(1F1B Schedule):
- 理想无气泡计算时长:
- 空转气泡时长:
- 气泡相对理想时间的比率(教材标准度量):
- 气泡占实际总运行时间的比例:
引入交错分片(Interleaved 1F1B, ):
- 气泡相对比率直接减半:
- 实际气泡墙钟占比降至:
- 显存与扩展性印证:在 1F1B 调度下,单卡最大激活驻留量被严格锁定在 个微批次之内。当微批次扩大至 时,气泡占比降至 ,跨节点集群效率达到最佳工业甜蜜点。
代码填空题
推导并验证各调度的 bubble 公式;生成 AFAB 调度矩阵并统计空闲比例。
Code
def bubble_ratio(scheme: str, p: int, m: int, v: int = 1) -> float:
    """
    bubble 相对理想时间的比例 r_bubble = 额外时间 / 理想时间。

    - naive: m=1(不分微批次),r = (p-1)/1
    - afab / 1f1b: r = (p-1)/m
    - interleaved: r = (p-1)/(v*m)
    """
    if scheme == "naive":
        return (p - 1) / 1
    if scheme in ("afab", "1f1b"):
        return ______          # 填空
    if scheme == "interleaved":
        return ______          # 填空
    raise ValueError(scheme)

def afab_schedule(p: int, m: int, tf: int = 1, tb: int = 1) -> list[list[int]]:
    """
    生成 AFAB 调度矩阵 busy[stage][t],1 = 该时刻该 stage 在计算。
    tf、tb 为前向/反向时长(整数,单位时间槽)。

    时序(0 起):
      stage i 的第 j 个前向  F_j 开始于 t = i + (j-1)*tf
      stage i 的第 j 个反向  B_j 开始于 t = (m + p - 1) + (p - 1 - i) + (j-1)*tb
    (先想清楚:最后一段前向在 t = m+p-2 结束;之后 stage p-1 立刻开始反向,
      反向像前向的镜像一样沿 stage 阶梯传播。)
    """
    total = (m + p - 1) * (tf + tb)
    busy = [[0] * total for _ in range(p)]
    for i in range(p):
        for j in range(m):
            t_f = i + (j - 1) * tf          # 填空点:如理解有出入可自行修正
            for u in range(tf):
                busy[i][t_f + u] = 1
            t_b = (m + p - 1) + (p - 1 - i) + (j - 1) * tb   # 填空点
            for u in range(tb):
                busy[i][t_b + u] = 1
    return busy

def idle_fraction(busy: list[list[int]]) -> float:
    """空闲槽位占比。"""
    total = sum(len(row) for row in busy)
    work = sum(sum(row) for row in busy)
    return ______                            # 填空

if __name__ == "__main__":
    p, m = 4, 8
    busy = afab_schedule(p, m)
    print("空闲比例:", f"{idle_fraction(busy):.3f}")
    # 理论值:bubble 比例(相对理想时间) = (p-1)/m;空闲占比 = (p-1)/(m+p-1)
    print("理论 (p-1)/(m+p-1) =", (p - 1) / (m + p - 1))
    assert abs(idle_fraction(busy) - (p - 1) / (m + p - 1)) < 1e-9

    for scheme, v in (("naive", 1), ("afab", 1), ("interleaved", 2)):
        r = bubble_ratio(scheme, p, m, v)
        print(f"{scheme:12s} v={v}  r_bubble = {r:.3f}")

    # 教材结论验证:m 远大于 p-1 时 bubble 小;v 再减半
    print("m=32:", f"{bubble_ratio('1f1b', 8, 32):.3f}")
    print("v=2 interleaved, m=32:", f"{bubble_ratio('interleaved', 8, 32, 2):.3f}")
三个问答题
Q1
为什么 AFAB 的激活显存随 m 增长而爆炸,1F1B 却能把它控制在约 p 个微批次的激活?请结合”各卡需要先做 PP 次前向才能开始第一次反向”解释教材的”每卡激活 ≈ activs(与不用 PP 相同)“这句话。
Q2
依次推导 naive、AFAB/1F1B、interleaved 的 bubble 比例公式,并说明每个公式里分子与分母的含义。为什么 1F1B 的 bubble 与 AFAB 相同,却仍然优于 AFAB?
Q3
zero bubble 的核心观察是什么?为什么 backward 中 W(权重梯度)可以在 B(输入梯度)之后任意时刻执行而不影响正确性?DualPipe 在此基础上又加了什么?最后对比:什么场景选 PP 而不是 ZeRO-3(至少两个依据)?
检查与通过标准
总分 10 分:代码正确 4 分(bubble 公式、AFAB 时序、空闲占比与理论一致)、三题各 2 分、通过线 8 分。
一票否决项:
- 认为 1F1B 减少 bubble(它与 AFAB 的 bubble 相同,省的是内存)。
- 把 bubble 公式中的 m 与 p 弄反。
- 说不出 interleaved 的通信代价是 ×v。
- 把 zero bubble 说成”消除了通信”(消除的是 bubble 空闲)。
- 认为 PP 会降低激活显存(PP 按层分片,激活不省)。