flowchart TD
    subgraph DataParallel["数据并行架构 (DDP)"]
        Data["全局 Batch 训练数据"] --> Split1["分片 0 (Rank 0)"]
        Data --> Split2["分片 1 (Rank 1)"]
        Data --> Split3["分片 2 (Rank 2)"]
        Split1 --> Model0["卡 0: 模型完整副本 W"]
        Split2 --> Model1["卡 1: 模型完整副本 W"]
        Split3 --> Model2["卡 2: 模型完整副本 W"]
        Model0 --> Grad0["本地梯度 g_0"]
        Model1 --> Grad1["本地梯度 g_1"]
        Model2 --> Grad2["本地梯度 g_2"]
        Grad0 & Grad1 & Grad2 --> AR["Ring AllReduce 全局同步"]
        AR --> Update["各卡同步更新同构参数 W_new"]
    end
第 4 课:数据并行 DP 与 DDP
参考答案版:包含完整代码实现与问答题深度参考解析。建议先独立完成练习题后再展开核对。
Important统一完成标准与及格线
代码 4 分、Q1~Q3 各 2 分,通过线 8/10。必须解释正确性边界、显存/通信公式中的单位与分片维度;未实际运行的内容只能标记为静态审查。
- 对应官方章节:Data Parallelism(含 Revisiting global batch size、Our journey up to now)
- 前置:第 2 课(梯度累积)、第 3 课(all-reduce)
- 状态:未开始
本课目标
完成后你需要能够:
- 把 DP 表述为”并行版梯度累积”,写出
gbs = mbs × grad_acc × dp。 - 解释为什么梯度 all-reduce 必须在 optimizer step 之前完成,但可以与 backward 重叠。
- 实现并解释两个优化:逐参数 hook 重叠、梯度 bucketing。
- 解释
no_sync在”DP + 梯度累积”中的正确性作用。 - 说明 DP 的边界:不降低每卡静态显存,规模过大(512+)时效率下降。
核心概念
1. 数据并行(DP/DDP)的数学本质与并行语义
数据并行(Data Parallelism)在数学本质上是空间维度展开的梯度累积。如图 4-1 与图 4-2 所示,整个集群拥有 个并行工作进程(Rank 0 至 Rank ),每个 GPU 显存内都完整存放了一份同构的模型参数副本 :
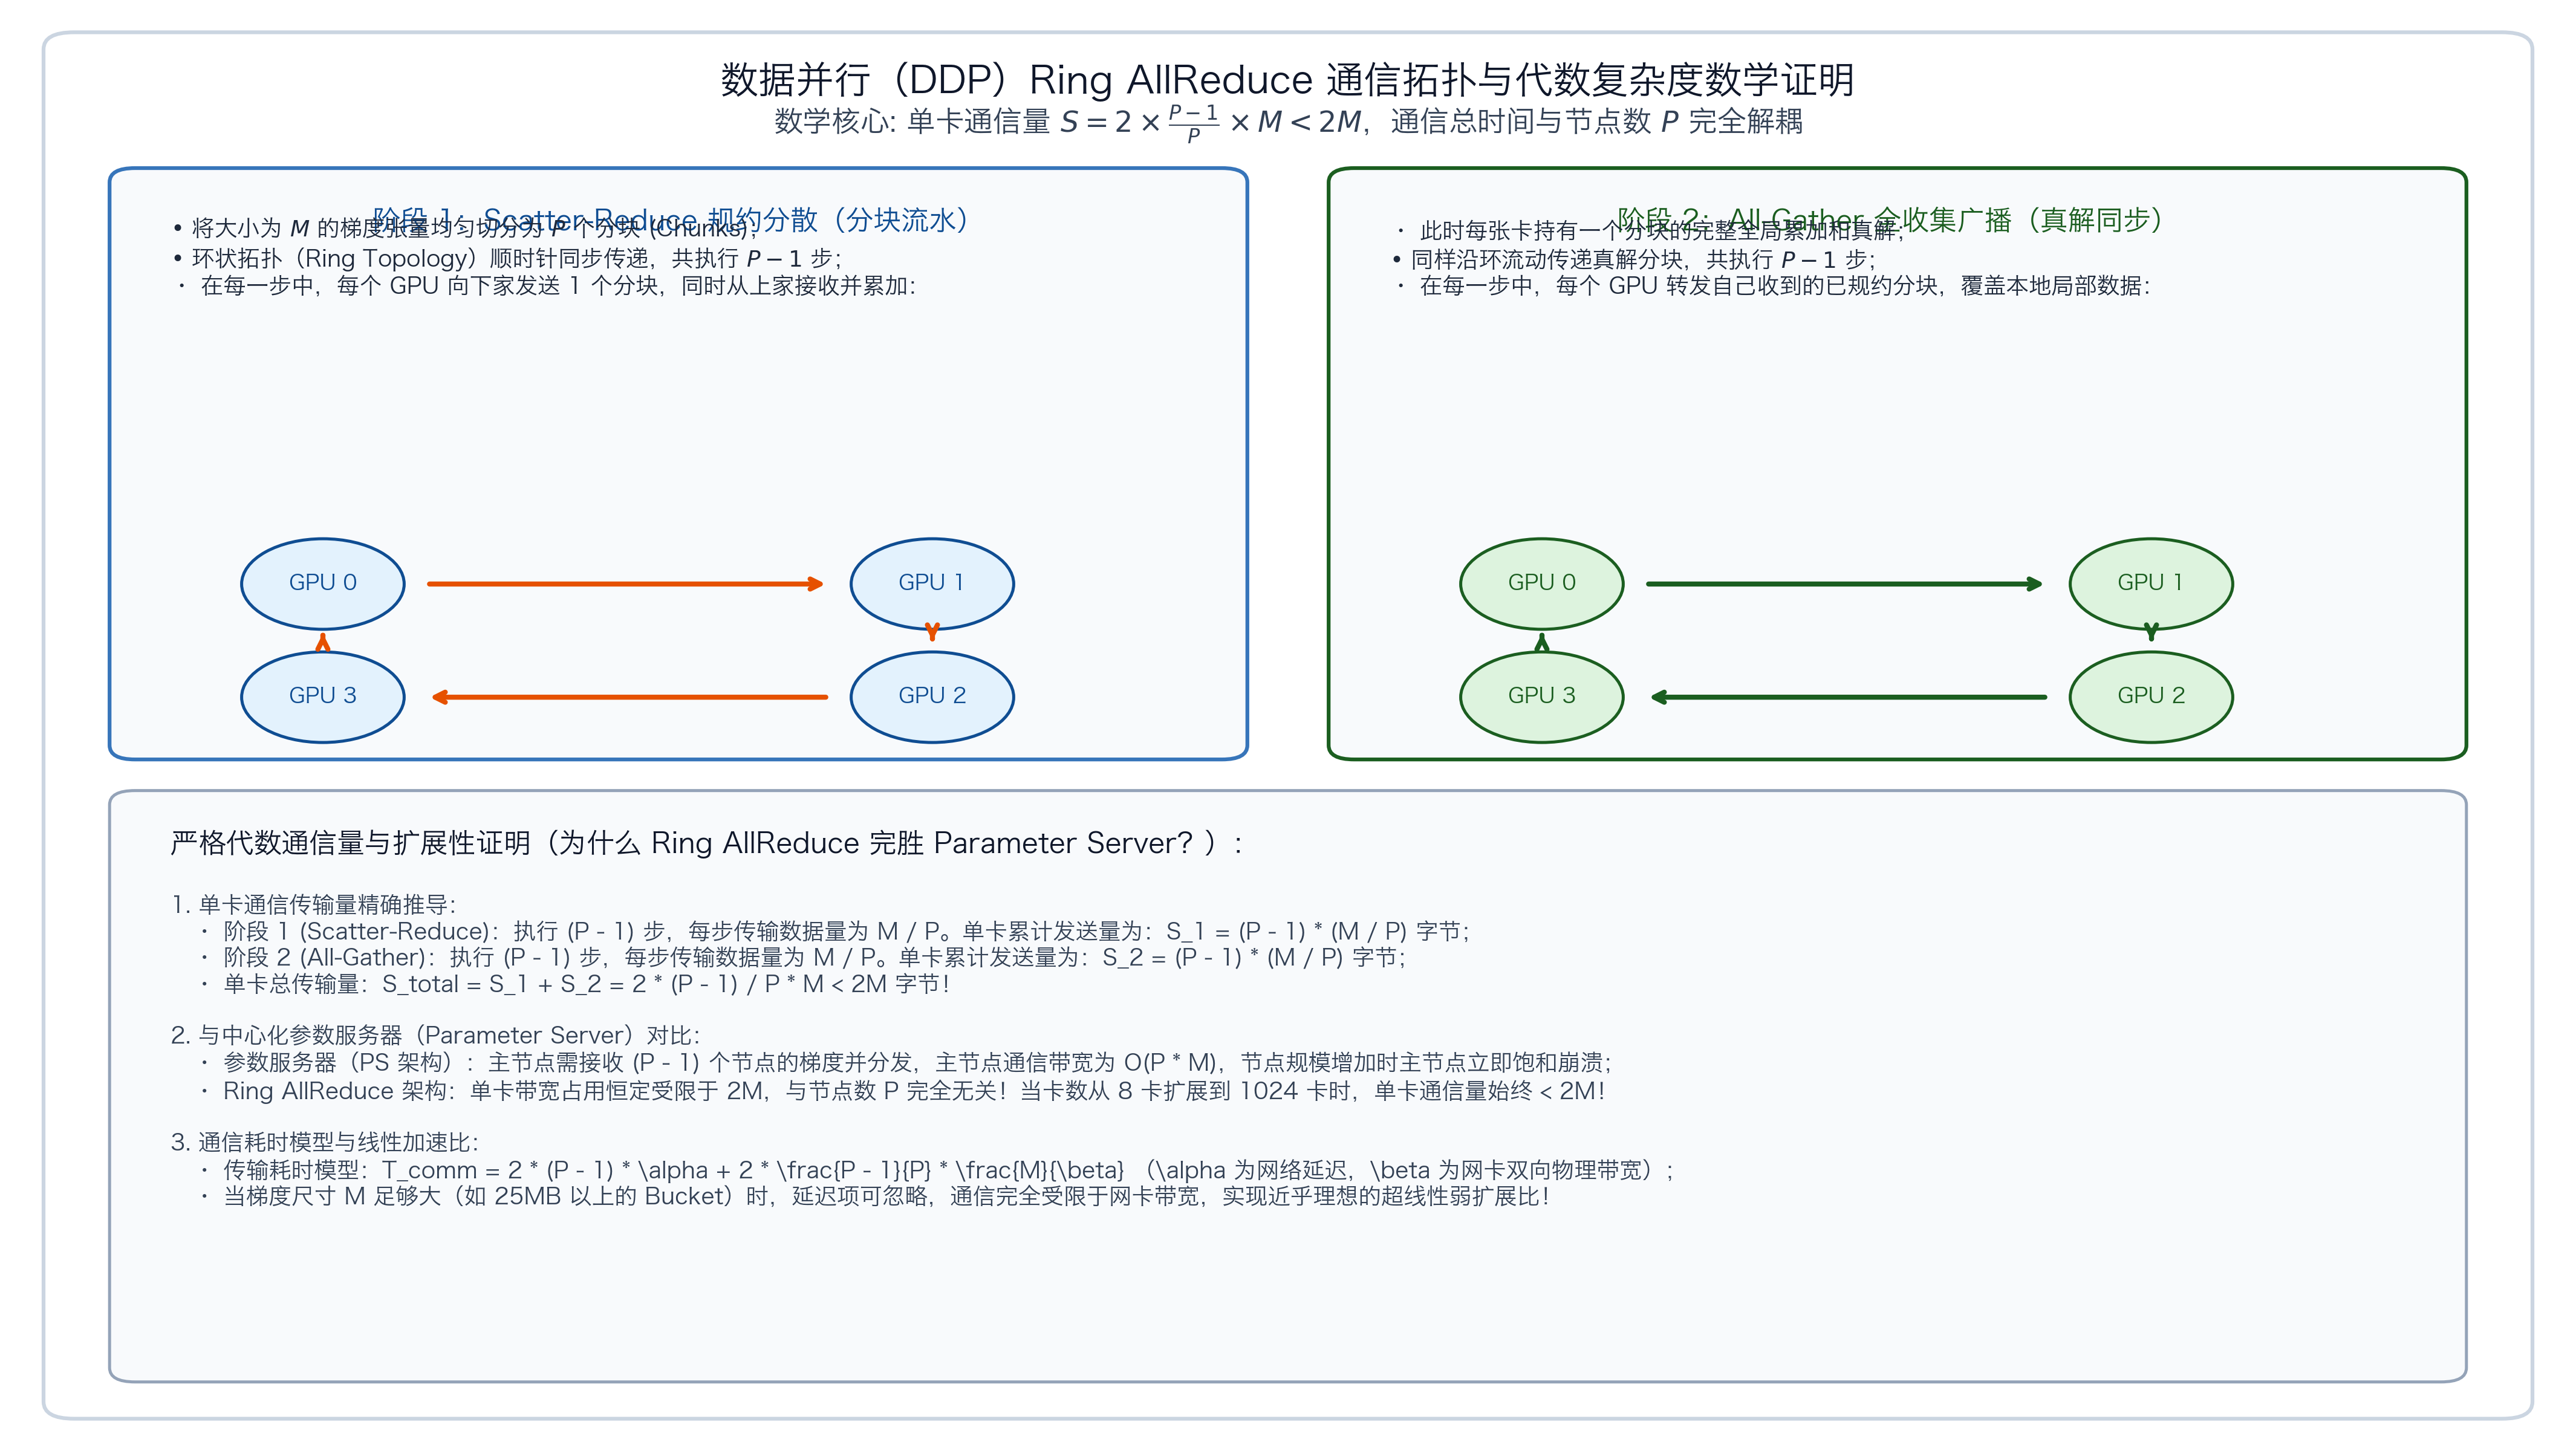
图 4-1:数据并行(DDP)Ring AllReduce 通信拓扑、分块流动与代数复杂度数学证明
图 4-2:数据并行(DDP)同构副本前向与全量梯度归约架构
当一个全局 Batch(Global Batch Size, GBS)的数据输入系统时,各 Rank 分别取走互不重叠的数据子集(Micro Batch, MBS)。由于各 Rank 上的前向传播与反向传播计算完全基于各自的本地数据进行,彼此之间没有任何数据依赖,因此计算阶段具备天然的完全并行性。
然而,优化器更新全局参数时,必须基于全局样本的真实平均梯度。设 ,全局目标损失对参数 的梯度定义为:
由此可见,每个 Rank 独立求导得到的仅是其本地分片的梯度之和。在执行优化器更新(optimizer.step())之前,必须通过第 3 课所讲的 AllReduce(求和后归一化除以 DP 规模) 算子,在所有参与数据并行的节点间同步梯度。这保证了所有副本在步结时取得完全相同的新权重 。
训练规模的核心计量维度公式为:
在维持全局 Batch 大小不变的前提下,增大 规模可以直接等比削减串行累积步数 ,从而大幅缩短每步训练的墙钟时间。
2. 朴素实现的瓶颈:计算与通信完全串行
在最原始的 DistributedDataParallel 朴素实现中,执行流程遵循严格的阶段式阻塞顺序:
前向与反向完全执行完毕:所有网络层反向计算结束,显存中产生所有参数的梯度张量。
一次性阻塞式 AllReduce:启动 NCCL 通信,将全模型参数量 对应的全部梯度张量进行同步传输。
优化器更新:等待通信全部完成后,统一更新权重。
这种串行逻辑存在巨大的算力浪费。其一步总耗时为:
在 Ring AllReduce 模式下,传输全模型梯度的网络通信时间为 。在万卡集群或跨节点低速网络(如普通以太网)下, 往往占据整步耗时的 30%~60%。在通信期间,数十万 TFLOPS 的 Tensor Core 处于完全空闲状态,吞吐极度低下。
3. 优化一:梯度后向钩子与通信隐藏(Post-Accumulate Grad Hook)
要消除空闲等待,核心思路是实现计算与通信的异步重叠(Overlap)。
注意到自动微分(Autograd)的反向传播是反向有向无环图(DAG)的倒序执行过程:从最后一层(输出层 Layer )逐层反向推进到第一层(输入层 Layer )。当输出层 Layer 的参数求导计算完毕时,其梯度 的数值已经完全确定,绝不会再受到后续浅层网络求导计算的影响。
现代 PyTorch DDP 内部通过为每个可训练参数注册底层回调(如 register_post_accumulate_grad_hook)实现通信重叠:
- 当反向计算图推进并生成参数 的梯度时,Hook 立即被触发。
- DDP 自动将该梯度的 AllReduce 异步投递到独立的 CUDA 通信流(
nccl_stream)中执行。 - 此时,默认的计算流(
compute_stream)无须任何等待,继续向前推进计算 Layer 、Layer 的反向求导。 - 只要浅层的反向计算耗时大于等于深层梯度的网络传输耗时,绝大部分通信时间就被反向计算完全掩盖( 隐藏在 背后)。
如图 4-3 所示,整个反向计算与网络传输在时间线上呈现高度交叠的双轨并发执行:
sequenceDiagram
    autonumber
    participant B as 反向求导 (Backward Compute)
    participant Bucket as 梯度分桶 (Bucket 0 / Bucket 1)
    participant NCCL as 异步通信流 (Ring AllReduce)
    Note over B,NCCL: PyTorch DDP 计算与通信重叠流水线
    B->>Bucket: 逐层反向求导 (Layer N)
    Bucket-->>Bucket: 梯度写入,达到阈值 (如 25MB)
    Bucket->>NCCL: 异步触发 AllReduce (Bucket 0)
    B->>Bucket: 继续求导上一层 (Layer N-1, N-2)
    Note right of NCCL: 环形通信与计算并行执行
    NCCL-->>NCCL: Bucket 0 同步完成
    Bucket->>NCCL: 异步触发 AllReduce (Bucket 1)
    NCCL-->>NCCL: 全部 Bucket 同步完毕
图 4-3:PyTorch DDP 梯度分桶与异步 AllReduce 计算通信重叠流水
4. 优化二:梯度分桶策略(Gradient Bucketing)
虽然逐参数挂载 Hook 理论上能实现最大程度的重叠,但在实际大模型中直接对每个小参数张量单独发起 AllReduce 会引发严重的性能倒退:
小包延迟开销爆炸:神经网络中包含大量极小的权重和偏置张量(例如 LayerNorm 的 scale/bias 仅数 KB)。根据第 3 课的网络延迟模型 ,当张量尺寸 很小时,耗时完全由每步通信固有的延迟基数 主导。成百上千次小包 AllReduce 会导致网络传输极其低效。
CUDA 算子发射开销(Kernel Launch Overhead):CPU 端频繁向 GPU 发射小张量通信算子会迅速跑满 CPU,导致 GPU 发生发射等待饥饿。
PyTorch DDP 采用分桶机制(Bucketing)进行折中处理:
- 按照网络模型反向求导完成的逆序方向,预先分配若干块连续的扁平内存切片(称为 Bucket,默认上限通常为
bucket_cap_mb = 25MB)。 - 各层的梯度产生后,先被直接拷贝(Copy)到对应的连续 Bucket 内存块中。
- 当一个 Bucket 被填满,或者倒序遍历到了该桶管辖的最后一层梯度时,系统才对这块规整的 25MB 大张量集中发射一次异步 Ring AllReduce。
- 这种策略既规避了小包通信的延迟惩罚,又避免了一次性同步全量模型带来的漫长等待,实现了网络总线利用率与重叠潜力的最优权衡。
5. 优化三:与梯度累积深度协同(no_sync 机制)
在显存受限而必须开启梯度累积(Gradient Accumulation)的场景下,若任由 DDP 在每一个 Micro-Batch 的反向阶段都自动触发分桶 AllReduce,将带来极其荒谬的算力与带宽浪费:
- 在累积步数 时,前 7 次 Micro-Batch 计算出的梯度在下一次计算时只是被就地累加(
grad += new_grad)。 - 如果每次都跨节点通信,不仅产生 的巨大冗余网络流量,而且中间的同步结果在下一次本地累加前毫无实际价值。
由于梯度求和满足数学上的加法结合律:
完全可以将各个 Micro-Batch 的梯度在单卡本地显存中纯算力累加,仅在最后第 次反向传播时执行一次全局 AllReduce 同步!
PyTorch DDP 提供了专用的上下文管理器 model.no_sync():
- 在
with model.no_sync():块内,DDP 会注销反向梯度的自动 AllReduce 挂钩,此时反向传播只在 GPU 本地累加梯度而不发起任何跨节点通信。 - 仅在累积周期的最后一个 Micro-Batch 脱离该上下文,触发单次全局 AllReduce。
- 该机制可将通信开销直接减少到未优化版本的 ,是单卡多步累积训练的黄金准则。
6. 工程细节与 DDP 的物理扩展边界
理解 DDP 的边界是掌握后续进阶并行架构(ZeRO、TP、PP)的前提:
通信内存开销:DDP 为梯度分桶分配的连续缓存区(Buckets)常驻在 GPU 显存中,通常会额外占用 25MB~50MB 的固定显存。同时,为了保证张量内存地址对齐与连续性,必要时会发生梯度复制。
DDP 完全无法降低每卡的静态显存:这是纯数据并行最致命的物理局限。每个 DDP 副本的 GPU 显存内都必须完整驻留 模型参数 、 梯度 以及 优化器状态(FP32 Master Weights + Momentum + Variance 共 字节)。
- 对于一个 70B 参数的 BF16 大模型,其静态状态显存高达 。
- 即使单卡显存配置到顶级的 80GB/192GB,并将 Micro-Batch 降为 1 且开启全激活重计算,单卡也根本无法容纳模型静态权重,程序将瞬间触发 OOM 崩溃。
网络扩展性极限(Ring Latency 惩罚):
- 当节点规模扩展到数百乃至数千卡(如 )时,Ring AllReduce 的延迟项 随着环形步数呈线性膨胀。跨交换机(Spine-Leaf 网络二跳/三跳)的延迟显著拉长。
- 当通信延迟超过了反向计算耗时时,异步重叠完全失效,算力利用率暴跌。
- 此时必须联合张量并行(TP,将计算切分到机内 NVLink 超高带宽域)以及流水线并行(PP,将层深切分),构成多维混合并行系统。
具体演示与数值推演
假设训练目标设定为全局吞吐 (即 tokens),上下文长度 ,则每步所需全局样本数为:
单卡在兼顾激活显存与算力饱和度的情况下,测定最大单卡批次 :
128 卡集群(): 每卡连续计算 4 个 Micro-Batch(前 3 个使用
no_sync纯本地累加,第 4 个触发异步 AllReduce),然后执行一次全局权重更新。512 卡集群(): 此时不需要任何梯度累加,每个 Micro-Batch 直接就是全局步,训练速度提升近 4 倍。
扩展性瓶颈突显: 在 512 卡场景下,反向计算时间缩短为单个 MBS=2 的计算耗时(假设为 80ms),但 512 卡跨节点 Ring AllReduce 的延迟开销与通信排队时间大幅增加(例如通信耗时上升至 120ms)。由于 ,异步重叠出现暴露窗口,GPU 产生 40ms 的通信气泡(Bubble)。继续无脑堆叠 DP 规模将陷入严重的边际收益递减。
代码填空题
补全以下程序:梯度分桶 + 朴素/重叠两种方案的完成时间模拟。
Code
from dataclasses import dataclass

@dataclass
class Bucket:
    names: list[str]      # 桶内梯度名(按反向完成顺序)
    total_bytes: int

def bucket_gradients(
    grads: list[tuple[str, int]],   # [(参数名, 梯度字节数)],按反向完成顺序(最后一层在前)
    bucket_bytes: int = 25 * 1024 * 1024,   # 默认桶大小 25 MB
) -> list[Bucket]:
    """
    贪心分桶:尽量把连续的梯度装进一个桶,直到装不下就开新桶。
    单个梯度超过桶上限时,单独成桶(不拆分)。
    """
    buckets: list[Bucket] = []
    cur_names: list[str] = []
    cur_bytes = 0

    for name, size in grads:
        if size > bucket_bytes:
            # 超大梯度:先把当前桶收尾,再单独成桶
            if cur_names:
                buckets.append(Bucket(cur_names, cur_bytes))
                cur_names, cur_bytes = [], 0
            buckets.append(Bucket([name], size))
        elif ______:      # 填空:判断当前桶是否还装得下
            cur_names.append(name)
            cur_bytes += size
        else:
            # 装不下:封桶,开新桶
            buckets.append(Bucket(cur_names, cur_bytes))
            cur_names, cur_bytes = ______   # 填空:新桶初始状态
            cur_names.append(name)
            cur_bytes += size

    if cur_names:
        buckets.append(Bucket(cur_names, cur_bytes))
    return buckets

def simulate_dp_step(
    layer_backward_s: list[float],    # 每层 backward 时长(顺序:最后一层 → 第一层)
    bucket_comm_s: list[float],       # 每桶 all-reduce 时长(顺序与分桶一致)
    overlap: bool,
) -> float:
    """
    模拟一次训练步的时间。

    - 反向是串行的:层 i 的 backward 必须等层 i-1 完成。
    - 每桶的通信可以在"该桶最后一层 backward 完成"后立即开始;
      多个桶的通信在同一通信流上串行排队。
    - naive(overlap=False):先全部 backward,再全部通信。
    - overlapped(overlap=True):通信在释放后立即开始,尽量与后续 backward 重叠。
    """
    # 每层 backward 的累计完成时刻
    finish = []
    acc = 0.0
    for t in layer_backward_s:
        acc += t
        finish.append(acc)

    if not overlap:
        # naive:总时间 = 全部 backward + 全部通信
        return ______

    # overlapped:通信任务按释放时间排队
    # 释放时刻 = 该桶所属最后一层 backward 完成时刻。
    # 简化模型:把层分成 len(bucket_comm_s) 段,每段一层或均分;
    # 桶 b 的释放时刻 = 该段最后一层的 finish。
    release = []
    seg = max(1, len(layer_backward_s) // len(bucket_comm_s))
    for b in range(len(bucket_comm_s)):
        end_layer = min(len(layer_backward_s) - 1, (b + 1) * seg - 1)
        release.append(finish[end_layer])

    # 通信流上串行执行:t = max(当前时间, 释放时刻) + 通信时长
    t_comm = 0.0
    for b in range(len(bucket_comm_s)):
        t_comm = ______(t_comm, release[b]) + bucket_comm_s[b]

    # 总时间 = max(backward 全部完成时刻, 通信流结束时刻)
    return max(finish[-1], t_comm)

def gbs_tokens(mbs: int, grad_acc: int, dp: int, seq: int) -> int:
    """全局 batch 大小(token 数)。"""
    return ______

if __name__ == "__main__":
    # 例:30 层,每层 backward 10ms;分 6 桶,每桶通信 12ms
    layer_t = [0.010] * 30
    bucket_comm = [0.012] * 6

    t_naive = simulate_dp_step(layer_t, bucket_comm, overlap=False)
    t_over = simulate_dp_step(layer_t, bucket_comm, overlap=True)
    print(f"naive = {t_naive * 1e3:.0f} ms, overlapped = {t_over * 1e3:.0f} ms")

    # 分桶统计
    grads = [(f"p{i}", 2 * 1024 * 1024) for i in range(40)]  # 每梯度 2MB
    buckets = bucket_gradients(grads, bucket_bytes=10 * 1024 * 1024)
    print("桶数:", len(buckets), "(不分组会是 40 次通信)")
    print("每桶字节:", [b.total_bytes // (1024 * 1024) for b in buckets])

    # 全局 batch 示例
    print("gbs_tokens:", gbs_tokens(mbs=2, grad_acc=4, dp=128, seq=4096))
三个问答题
Q1
为什么梯度同步必须在 optimizer step 之前完成?为什么它可以(部分)与 backward 重叠,而第 6 课将看到 TP 的通信”在关键路径上、难以重叠”?两者有什么本质区别?
Q2
DP + 梯度累积时,为什么可以用 no_sync() 只在最后一次 backward 后 all-reduce?请从运算性质(结合律)说明正确性,并定量比较:grad_acc=8、dp=64 时,“每次都同步”与”只同步一次”的通信次数差多少倍?
Q3
教材说 DP 在 512+ 卡时效率明显下降,且 DP 不降低每卡显存。请解释这两个限制分别来自哪里,并说明:一个 70B 模型在 8×80GB 节点上训练,为什么纯 DP(含 grad_acc)无法解决”模型装不下”的问题?此时应该转向哪些技术(给出名字即可)?
检查与通过标准
总分 10 分:代码正确 4 分(分桶条件、时间模拟、gbs 公式)、三题各 2 分、通过线 8 分。
一票否决项:
- 认为 DP 可以降低每卡参数/优化器显存。
- 认为”每次 backward 都同步”与”最后一次同步”在结果上不等价。
- 不知道 all-reduce 是求和(平均需要再除以 dp)或同步时机错误。
- 声称”DP 规模可以无限扩展”或”DP 能解决模型放不下单卡的问题”。