flowchart LR
    subgraph ContextPartition["上下文并行长序列切分"]
        Seq["超长序列 S (如 128k Tokens)"] --> C0["分块 Chunk 0 -> GPU 0"]
        Seq --> C1["分块 Chunk 1 -> GPU 1"]
        Seq --> C2["分块 Chunk 2 -> GPU 2"]
        Seq --> C3["分块 Chunk 3 -> GPU 3"]
    end
第 8 课:上下文并行 CP
参考答案版:包含完整代码实现与问答题深度参考解析。建议先独立完成练习题后再展开核对。
Important统一完成标准与及格线
代码 4 分、Q1~Q3 各 2 分,通过线 8/10。必须解释正确性边界、显存/通信公式中的单位与分片维度;未实际运行的内容只能标记为静态审查。
- 对应官方章节:Context Parallelism / Ring Attention / Zig-Zag Ring Attention
- 前置:第 3 课(all-gather / all-to-all 概念)、第 7 课(SP)
- 状态:未开始
本课目标
完成后你需要能够:
- 说明 CP 与 SP 的区别:CP 沿序列切分整个模型(含 attention),独立于 TP 使用。
- 推演 Ring Attention 的三步循环,说明为什么注意力是唯一需要跨卡通信的模块。
- 解释朴素 Ring Attention 在因果掩码下的负载不均,以及 Zig-Zag 如何均衡。
- 对比 all-gather 与 all-to-all(ring)两种 K/V 交换实现的取舍。
核心概念
1. 上下文并行(CP)的提出背景与第一性原理
随着大语言模型应用从短文本对话演进到长文档分析、代码库解析、超长推理(如 128k、256k 乃至 1M 上下文),系统显存面临着序列长度 引发的非线性膨胀危机:
- 自注意力机制二次方显存:原生 Attention 的分数矩阵维度为 ,显存复杂度为 ;即便采用 FlashAttention 避免物化分数矩阵,前向与反向中的输入/输出激活、残差连接以及 KV 缓存显存仍然随 呈线性增长。在 128k 序列下,仅单样本激活显存就高达数百吉字节。
- TP 扩展性的物理壁障:第 6 课已指出,张量并行(TP)受限于机内 NVLink 超高带宽,通常最大只能取 。仅靠机内 TP 无法跨机扩展以消化百万级别的超长序列。
上下文并行(Context Parallelism, CP)应运而生。如图 8-1 与图 8-2 所示,CP 是一种全局序列分块并行架构:
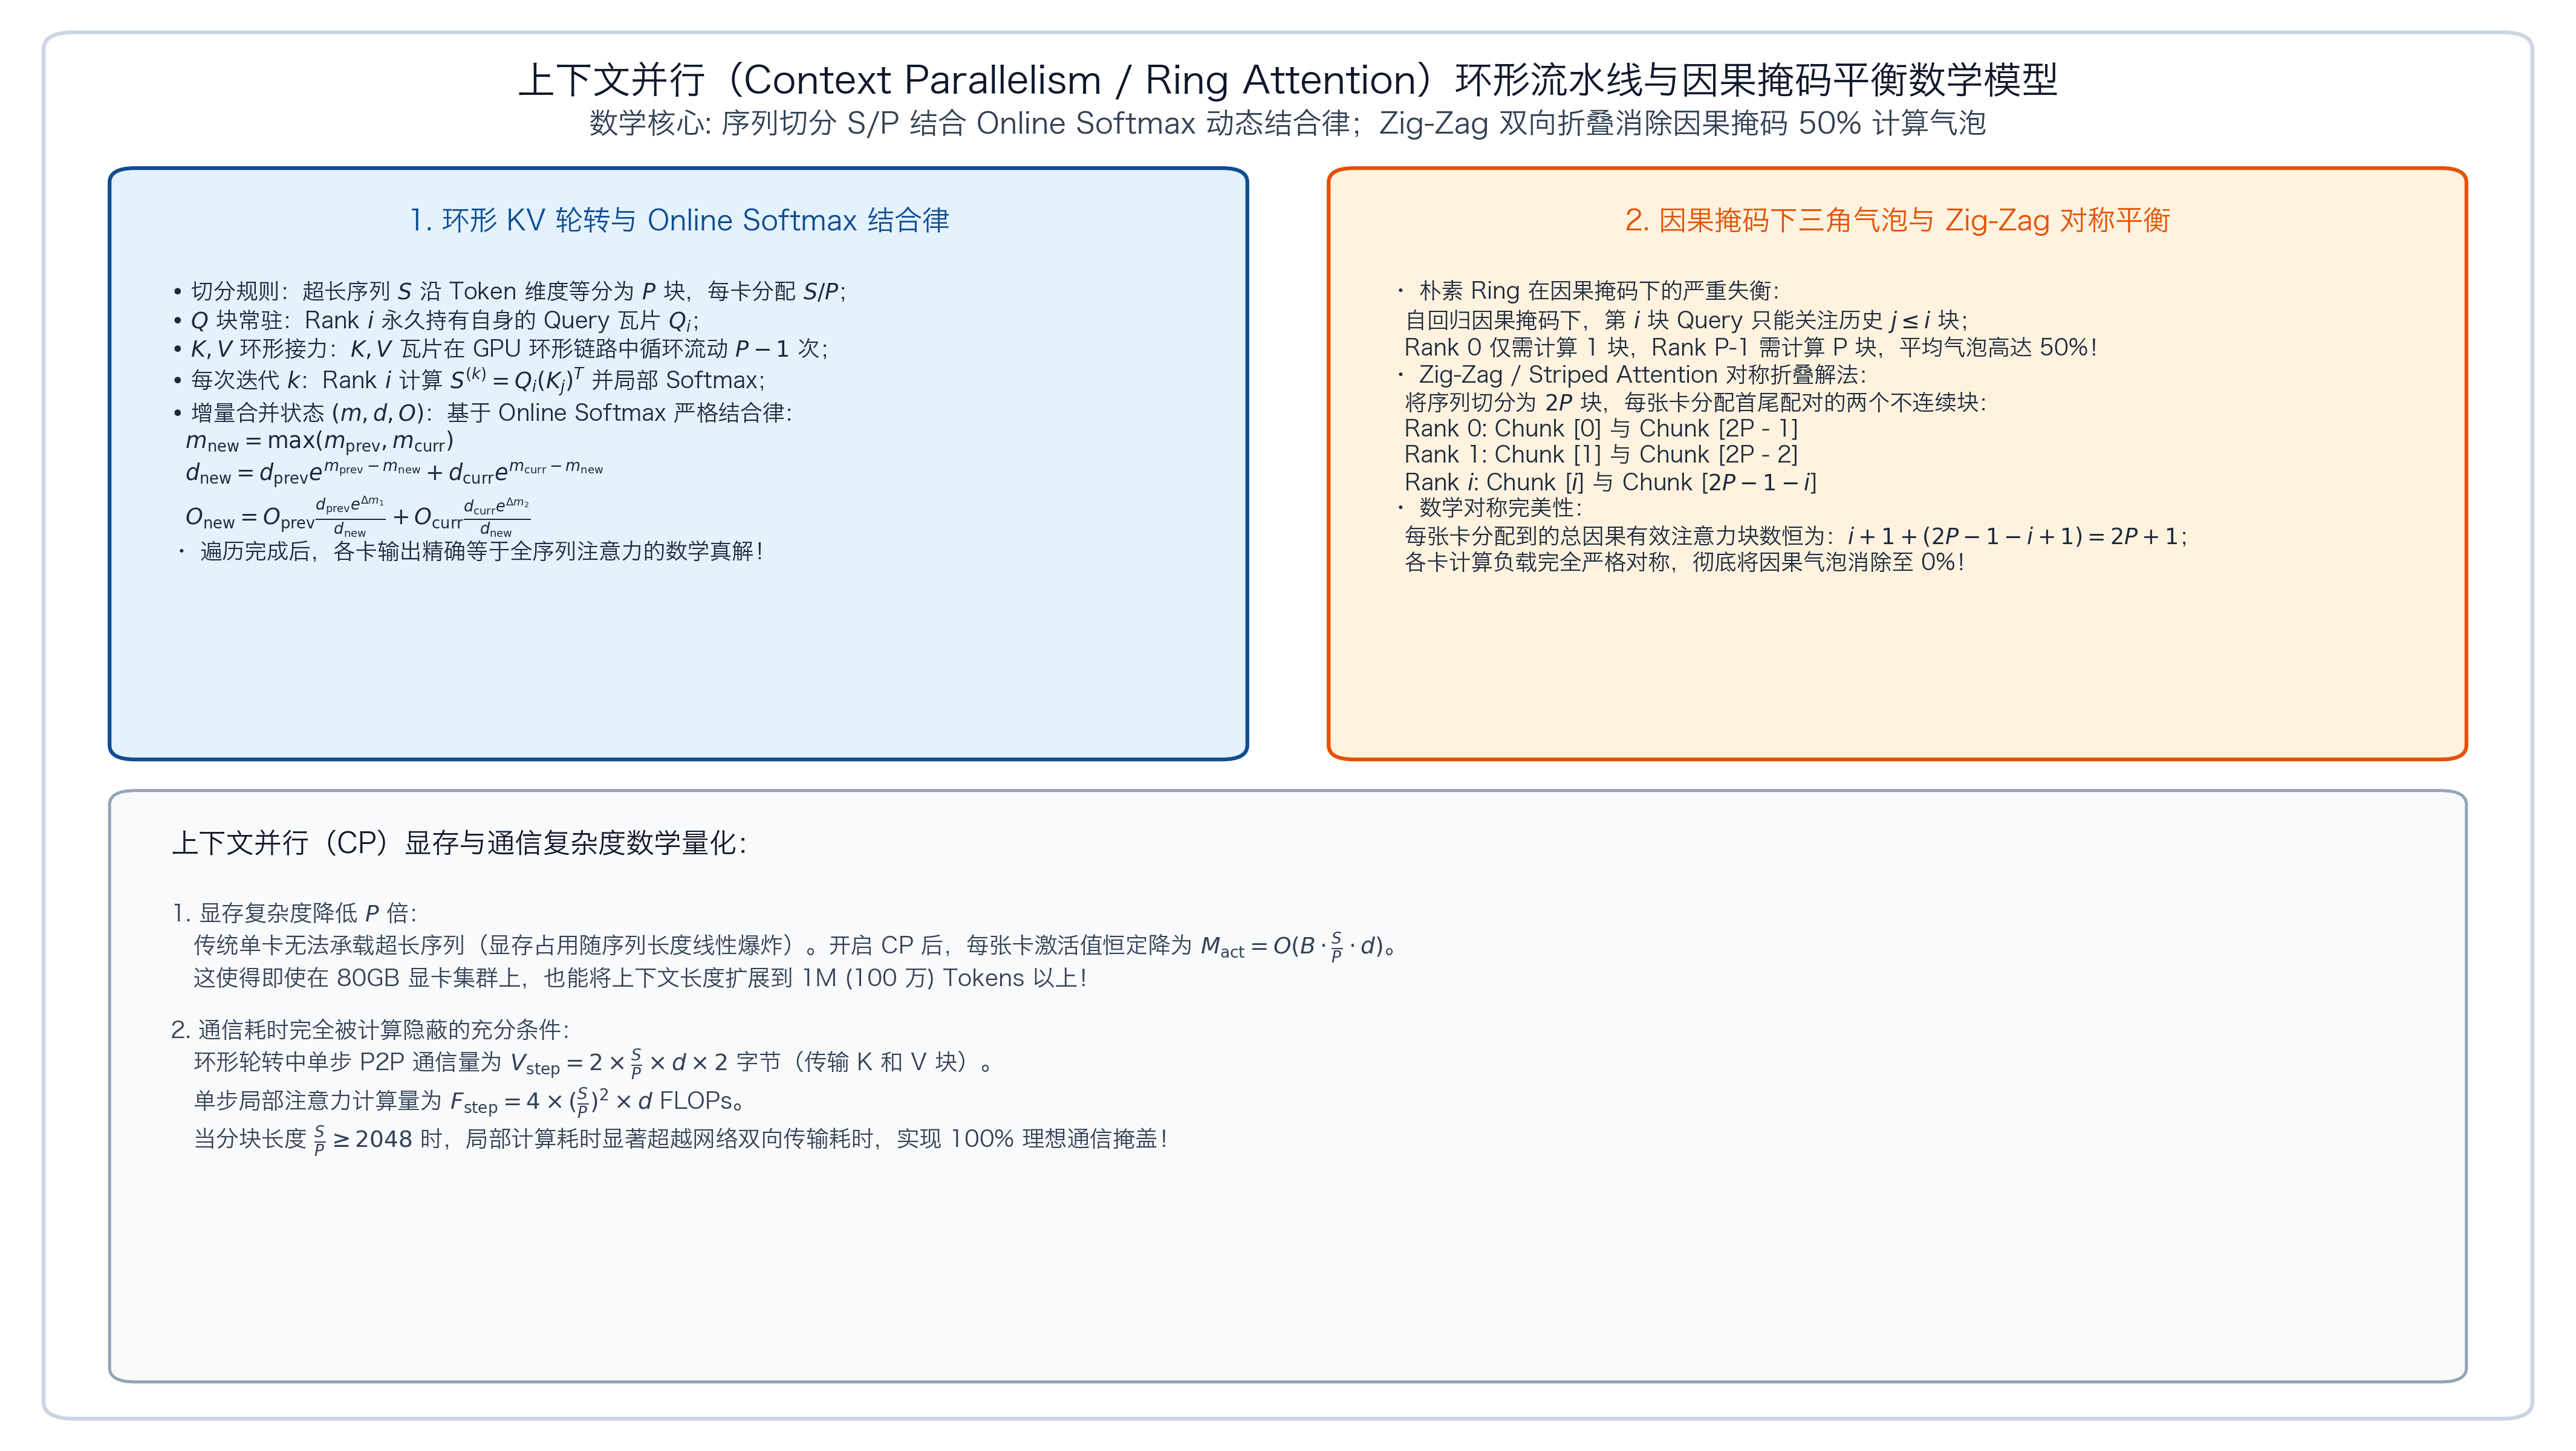
图 8-1:上下文并行(Context Parallelism / Ring Attention)环形流水线与因果掩码平衡数学模型
图 8-2:上下文并行按序列切块并分配至独立 GPU 拓扑
- 它将长达 的输入序列在最外层直接沿序列维度均匀切分为 个子序列片段,分配给集群中的 张 GPU(通常跨物理节点,结合 RDMA 网络)。
- 每张 GPU 分配到的局部序列长度仅为 。
- 与逐 Token 算子的天然正交性:Transformer 中的 MLP(Feed-Forward)、LayerNorm/RMSNorm、Embedding 以及各类残差连接完全是逐 Token 独立计算(Token-wise)的。在 CP 模式下,这些模块在各卡上进行完全本地的张量运算,全程产生 0 跨卡通信开销!
- 自注意力的唯一性挑战:整个网络中,唯独多头自注意力(Self-Attention)模块打破了 Token 间的独立性——根据 Attention 公式 ,每个 Token 的 Query 必须与全序列所有历史 Token 的 Key/Value 进行点积计算。因此,如何在各 GPU 仅持有局部切片的前提下,低显存、高带宽地计算出全量注意力,是 CP 的核心难题。
2. Ring Attention 的环形流转与异步重叠机制
为了解决注意力跨卡计算的问题,UC Berkeley 提出了经典的 Ring Attention(环形注意力) 算法。其核心思想是:让局部 Query 始终固定在本地显存,而让 Key/Value 块沿着逻辑通信环异步流转轮巡。
如图 8-3 所示,整个通信与计算流水线由双缓冲(Double Buffering)机制驱动:
sequenceDiagram
    autonumber
    participant GPU0 as GPU 0 (Q_0 固定)
    participant GPU1 as GPU 1 (Q_1 固定)
    participant P2P as 环形 P2P 异步通信 (KV 轮转)

    Note over GPU0,GPU1: Step 0: 计算本地 Q_i 与 K_i, V_i 的注意力
    GPU0->>P2P: 发送 K_0, V_0 -> GPU 1,接收来自前驱的 KV
    GPU1->>P2P: 发送 K_1, V_1 -> GPU 2,接收来自前驱的 KV
    Note over GPU0,GPU1: Step 1: 异步接收下一块 KV,同时计算当前重叠块注意力
    Note over GPU0,GPU1: 利用 Online Softmax 动态更新分母与局部输出,无需中间显存
图 8-3:Ring-Attention 环形 KV 轮转与双缓冲通信计算重叠流程
初始状态:每个 Rank 均持有本地的子序列块 ,形状均为 。
步环形流水循环:在每一个时间步 :
- 异步通信启动:通信流启动非阻塞 P2P 传输(
dist.isend与dist.irecv),将当前卡持有的 块异步投递给环形拓扑的下一个邻居 ,同时异步接收来自上一个邻居 的新 块。 - 计算与通信重叠:在后台网络传输的同时,GPU 计算流在本地执行矩阵乘:将固定的本地 与当前持有的 计算局部注意力,并通过 Online Softmax 算法就地合并、缩放并累加到本地的上下文输出张量 中。
- 同步与双缓冲轮换:计算完毕后,等待后台异步 P2P 传输收包完成,交换当前缓冲区与接收缓冲区(Buffer Swap),进入下一轮迭代。
- 异步通信启动:通信流启动非阻塞 P2P 传输(
显存恒定特性:在整个环形轮转过程中,每张卡只需要额外保留用于接收下一个块的临时 KV 双缓冲空间。每卡显存仅为 ,与全网序列总长度 的膨胀完全解耦!
3. 与 FlashAttention 的理论同源性:Online Softmax
为什么可以将原本需要全量点积的 Softmax 拆分成小块分别计算?其数学基石正是 Online Softmax(亦是 FlashAttention 的核心,第 13 课将详解其 CUDA 实现)。
在朴素计算中,Softmax 的分母需要全序列求和:。若简单地对每个块独立做 Softmax 再拼接,会导致各块的分母归一化基准不一致,计算结果必然完全错误。
Ring Attention 在本地维护三个统计状态量:
- :当前已见所有 KV 块的最大点积分数(用于防止指数溢出);
- :当前已见所有 KV 块的归一化指数和;
- :当前累积的局部加权输出向量。
当第 个新的 KV 块到达,产生局部点积分数 时: 这保证了在 轮迭代结束时,本地输出 与全量非分块注意力算出的结果在数值上完全等价!
4. 因果掩码下的严重负载失衡与 Zig-Zag 拓扑平衡
在自回归因果语言模型(Autoregressive / Causal LLM)中,注意力矩阵呈下三角掩码结构:位置为 的 Query 只能 Attend 历史位置 的 Key/Value,未来的 Token 全被掩码置零(Masked Out)。
A. 朴素连续切分的灾难性失衡
若将长序列简单地连续切片(例如 4 卡场景,Rank 0 分得 ,Rank 3 分得 ):
- Rank 0:持有的 Query 全部位于序列最前端。它只需要与本地的 KV 块计算,其余 3 个远端发来的 KV 块全部处于未来时间步,计算量全部为 0!Rank 0 在第 1 步后就陷入彻底的空转饥饿。
- Rank 3:持有的 Query 全部位于序列末尾。它必须与集群中所有 4 个 KV 块全部进行点积运算,工作量高达 Rank 0 的 4 倍!
- 气泡率(Bubble Rate):在下三角注意力矩阵下,纯连续切分的总有效计算量仅为方阵的 ,但由于木桶效应,每轮必须等待最慢的 Rank 3,系统整体算力浪费高达近 !
B. Zig-Zag Ring Attention 的数学自洽解
为了彻底消除这种空转,Zig-Zag Ring Attention 改变了分块映射策略:让每张 GPU 同时持有一块“序列开头的早 Token”和一块“序列末尾的晚 Token”!
设每个 Rank 分配 个 Chunk,全序列共 个块。Zig-Zag 按照如下规律交错分配: 以 为例:
- Rank 0: Chunk
- Rank 1: Chunk
- Rank 2: Chunk
- Rank 3: Chunk
因果掩码下,第 个 Query Chunk 需要计算的有效 KV 块数量恰为 。因此,Rank 的总计算工作量为: 变量 被完全抵消! 对于任意 Rank ,其总工作量恒等于常数 (例如 4 卡下每张卡精确分得 个块的计算任务)。算力利用率瞬间达到 ,计算气泡被彻底抹平!
5. 两种工程通信实现:All-to-All / Ring vs All-Gather
在主流大模型框架中,上下文并行存在两种流派:
| 特性维度 | Ring Attention (逐块 P2P 轮转) | DeepSpeed Ulysses (All-to-All 转置) |
|---|---|---|
| 通信拓扑 | 环形单向 P2P (isend/irecv) |
全交换 All-to-All (类似数据转置) |
| 显存占用 | 极低 (),仅需双缓冲 | 较高,注意力阶段每卡需完整容纳自身负责头的所有序列 KV |
| 通信-计算重叠 | 极佳:P2P 传输完全被单块计算掩盖 | 难以重叠:进入注意力前必须等待 All-to-All 同步完成 |
| 对注意力头数依赖 | 完全无约束,头数少于 亦可运行 | 强约束:注意力头数必须能被 整除 |
| 长文本极限 | 适合百万级(1M+)超长序列 | 适合中长(32k~64k)且节点间全互联场景 |
具体演示与数值推演
设集群规模为 张 GPU,全序列划分为 8 个 Chunk(编号 0 至 7,因果掩码下 Chunk 合法 Attend 的 KV 范围是 ):
- 朴素连续分配方案(Sequential Assignment):
- 各卡持有的 Chunk:Rank 0: ,Rank 1: ,Rank 2: ,Rank 3: 。
- 各卡有效计算对数:
- Rank 0: 对
- Rank 1: 对
- Rank 2: 对
- Rank 3: 对
- 失衡分析:最大负载(15)是最小负载(3)的 5.0 倍!Rank 0 大部分时间处于等待阻塞状态。
- Zig-Zag 镜像分配方案(Zig-Zag Assignment):
- 各卡持有的 Chunk:Rank 0: ,Rank 1: ,Rank 2: ,Rank 3: 。
- 各卡有效计算对数:
- Rank 0: 对
- Rank 1: 对
- Rank 2: 对
- Rank 3: 对
- 均衡分析:所有卡的工作量均严格等于 9 对,达到绝对的完美负载均衡!虽然每张卡都需要与环上其他卡发生数据交换,但单卡发送与接收的总通信量恒定为 ,没有产生任何额外的数据膨胀。
代码填空题
模拟 chunk 分配与 Ring Attention 轮转,验证 Zig-Zag 的负载均衡。
Code
def sequential_assignment(num_ranks: int, chunks_per_rank: int):
    """
    朴素连续分配:rank r 拿连续的 chunks_per_rank 个 chunk。
    返回 dict: rank -> chunk 序号列表(chunk 从 0 开始编号)。
    """
    assign = {}
    for r in range(num_ranks):
        assign[r] = ______   # 填空:第 r 个 rank 拿到的 chunk 列表
    return assign

def zigzag_assignment(num_ranks: int, chunks_per_rank: int):
    """
    Zig-Zag:第 r 个 rank 交替从序列两头取。
    序号:rank r 第 k 个 chunk 的全局编号。
    规则:编号 < num_ranks 的 chunk 正序发(chunk r 给 rank r);
          超过后反向交错:chunk (2*num_ranks - 1 - r) 给 rank r。
    对 chunks_per_rank = 2(最常见的 2 chunk/卡):rank r 拿 {r, 2p-1-r}。
    """
    total = num_ranks * chunks_per_rank
    assign = {}
    for r in range(num_ranks):
        chunks = []
        for k in range(chunks_per_rank):
            # 填空:交替取数公式(奇数块从尾部取)
            if k % 2 == 0:
                chunks.append(______)      # 正序:第 k/2 轮正序编号
            else:
                chunks.append(______)      # 反序:从尾端回推
        assign[r] = chunks
    return assign

def causal_workload(assign: dict[int, list[int]], num_chunks: int) -> dict[int, int]:
    """
    因果掩码下每个 rank 需要计算的 (q_chunk, kv_chunk) 对数。
    一个 rank 有多个 query chunk 时,工作量 = Σ_q (q 号 + 1),
    因为 q 可以 attend kv_chunk 0..q(因果)。
    """
    workload = {}
    for r, q_chunks in assign.items():
        total = 0
        for q in q_chunks:
            total += ______                # 填空:该 query chunk 的合法 kv 数量
        workload[r] = total
    return workload

def ring_rotation(num_ranks: int, rank: int, start_chunk: int) -> list[int]:
    """
    Ring Attention 轮转:返回该 rank 在每一步(0..num_ranks-1)持有的
    K/V chunk 编号(K/V 沿环每步前进一个 rank)。
    第 t 步:本 rank 的 K/V 来自上游 t 步前出发的 chunk。
    """
    steps = []
    for t in range(num_ranks):
        steps.append(______)               # 填空:(start + t) 沿环回绕
    return steps

if __name__ == "__main__":
    p = 4
    seq_assign = sequential_assignment(p, 2)
    zz_assign = zigzag_assignment(p, 2)
    print("sequential:", seq_assign)
    print("zig-zag   :", zz_assign)

    w_seq = causal_workload(seq_assign, p * 2)
    w_zz = causal_workload(zz_assign, p * 2)
    print("sequential workload:", w_seq, " max/min =", max(w_seq.values()) / min(w_seq.values()))
    print("zig-zag workload   :", w_zz, " max/min =", max(w_zz.values()) / min(w_zz.values()))
    assert len(set(w_zz.values())) == 1, "zig-zag 应完全均衡"
    print("Zig-Zag 负载完全均衡 ✓")

    # Ring 轮转示例:rank 2 的 K/V 持有序列
    print("rank 2 轮转:", ring_rotation(p, 2, 2))
三个问答题
Q1
CP 中为什么只有 attention 模块需要跨卡通信?为什么交换的是 K/V 而不是 Q?如果把整条序列的 K/V 一次性复制到每卡(all-gather 式),与 ring 式相比显存和延迟各付出什么代价?
Q2
用因果掩码解释为什么朴素连续切分下”GPU 1 立即算完、GPU 4 要等三轮”,并说明 Zig-Zag 为什么能均衡负载。Zig-Zag 下每个 rank 需要从其他所有 rank 获得 K/V,这是否增加总通信量?
Q3
教材指出 Ring Attention 与 FlashAttention 都依赖 online softmax。请解释:分块计算注意力时,为什么不能简单地对每个块分别 softmax 再拼接?还需要维护哪些额外统计量?(可以只给概念,第 13 课会用代码实现。)
检查与通过标准
总分 10 分:代码正确 4 分(分配公式、工作量统计、轮转公式、均衡验证)、三题各 2 分、通过线 8 分。
一票否决项:
- 分不清 CP 与 SP(本书定义)。
- 认为 CP 中 MLP/LayerNorm 也需要跨卡交换激活。
- 说不出因果掩码导致负载不均的具体机制。
- 认为”分别 softmax 再拼接”是正确做法。