flowchart TD
    subgraph BlockGEMM["分块矩阵乘 (BLOCK_M × BLOCK_N)"]
        A_k["A 瓦片 (BLOCK_M × BLOCK_K)"]
        B_k["B 瓦片 (BLOCK_K × BLOCK_N)"]
        Acc["累加器 accumulator (FP32 精度)"]
        A_k & B_k -->|"tl.dot(a, b, acc)"| Acc
    end
第 9 课:Blocked Matmul 与 FP32 累加
参考答案版:包含完整代码实现与问答题深度参考解析。建议先独立完成练习题后再展开核对。
本课目标与完成标准
学完后你应能:实现带 K 尾块的 blocked matmul,解释 accumulator、mask 和 autotune 维度。
通过必须同时满足:
- 独立补齐本课唯一的代码填空题,并通过给定检查;
- 三个问答题均说明因果链,而不是只报术语;
- 能指出至少一个正确性边界和一个性能取舍;
- 总分不低于 8/10,且没有一票否决级概念错误。
前置关系
- 课程前置:Python、PyTorch 张量、CUDA 基本线程/内存概念
- 本课在路线中的作用:Triton GEMM 用二维 program grid 负责 C tile,在 K 维循环加载 A/B tiles 并用
tl.dot累加。
核心心智模型
1. 它是什么,解决什么问题
通用矩阵乘法(GEMM: ,)是现代人工智能模型(Transformer、CNN、MoE)中计算量占比超过 95% 的绝对算力支柱。 在 GPU 体系结构中,朴素的三重循环算法算术强度极低,会导致致命的显存带宽瓶颈。因此,高性能 GEMM 必须采用二维输出分块(Blocked Tiling): 网格划分为 的宏观瓦片,每个 Program 块负责计算并写回输出矩阵的一小块 ;在内层沿 维以跨步 循环切片,并在片上高速寄存器中不断执行外积累加。 本课解决的核心工程问题是:在 Triton 中如何使用 tl.dot 驱动硬件底层 Tensor Core 核心,如何通过 FP32 累加器维持混合精度数值稳定性,以及如何为 三维独立施加谓词掩码,优雅处理任意非对齐的尾块尺寸。
2. 它如何工作
分块矩阵乘瓦片流水线如图 9-1 至图 9-3 所示:
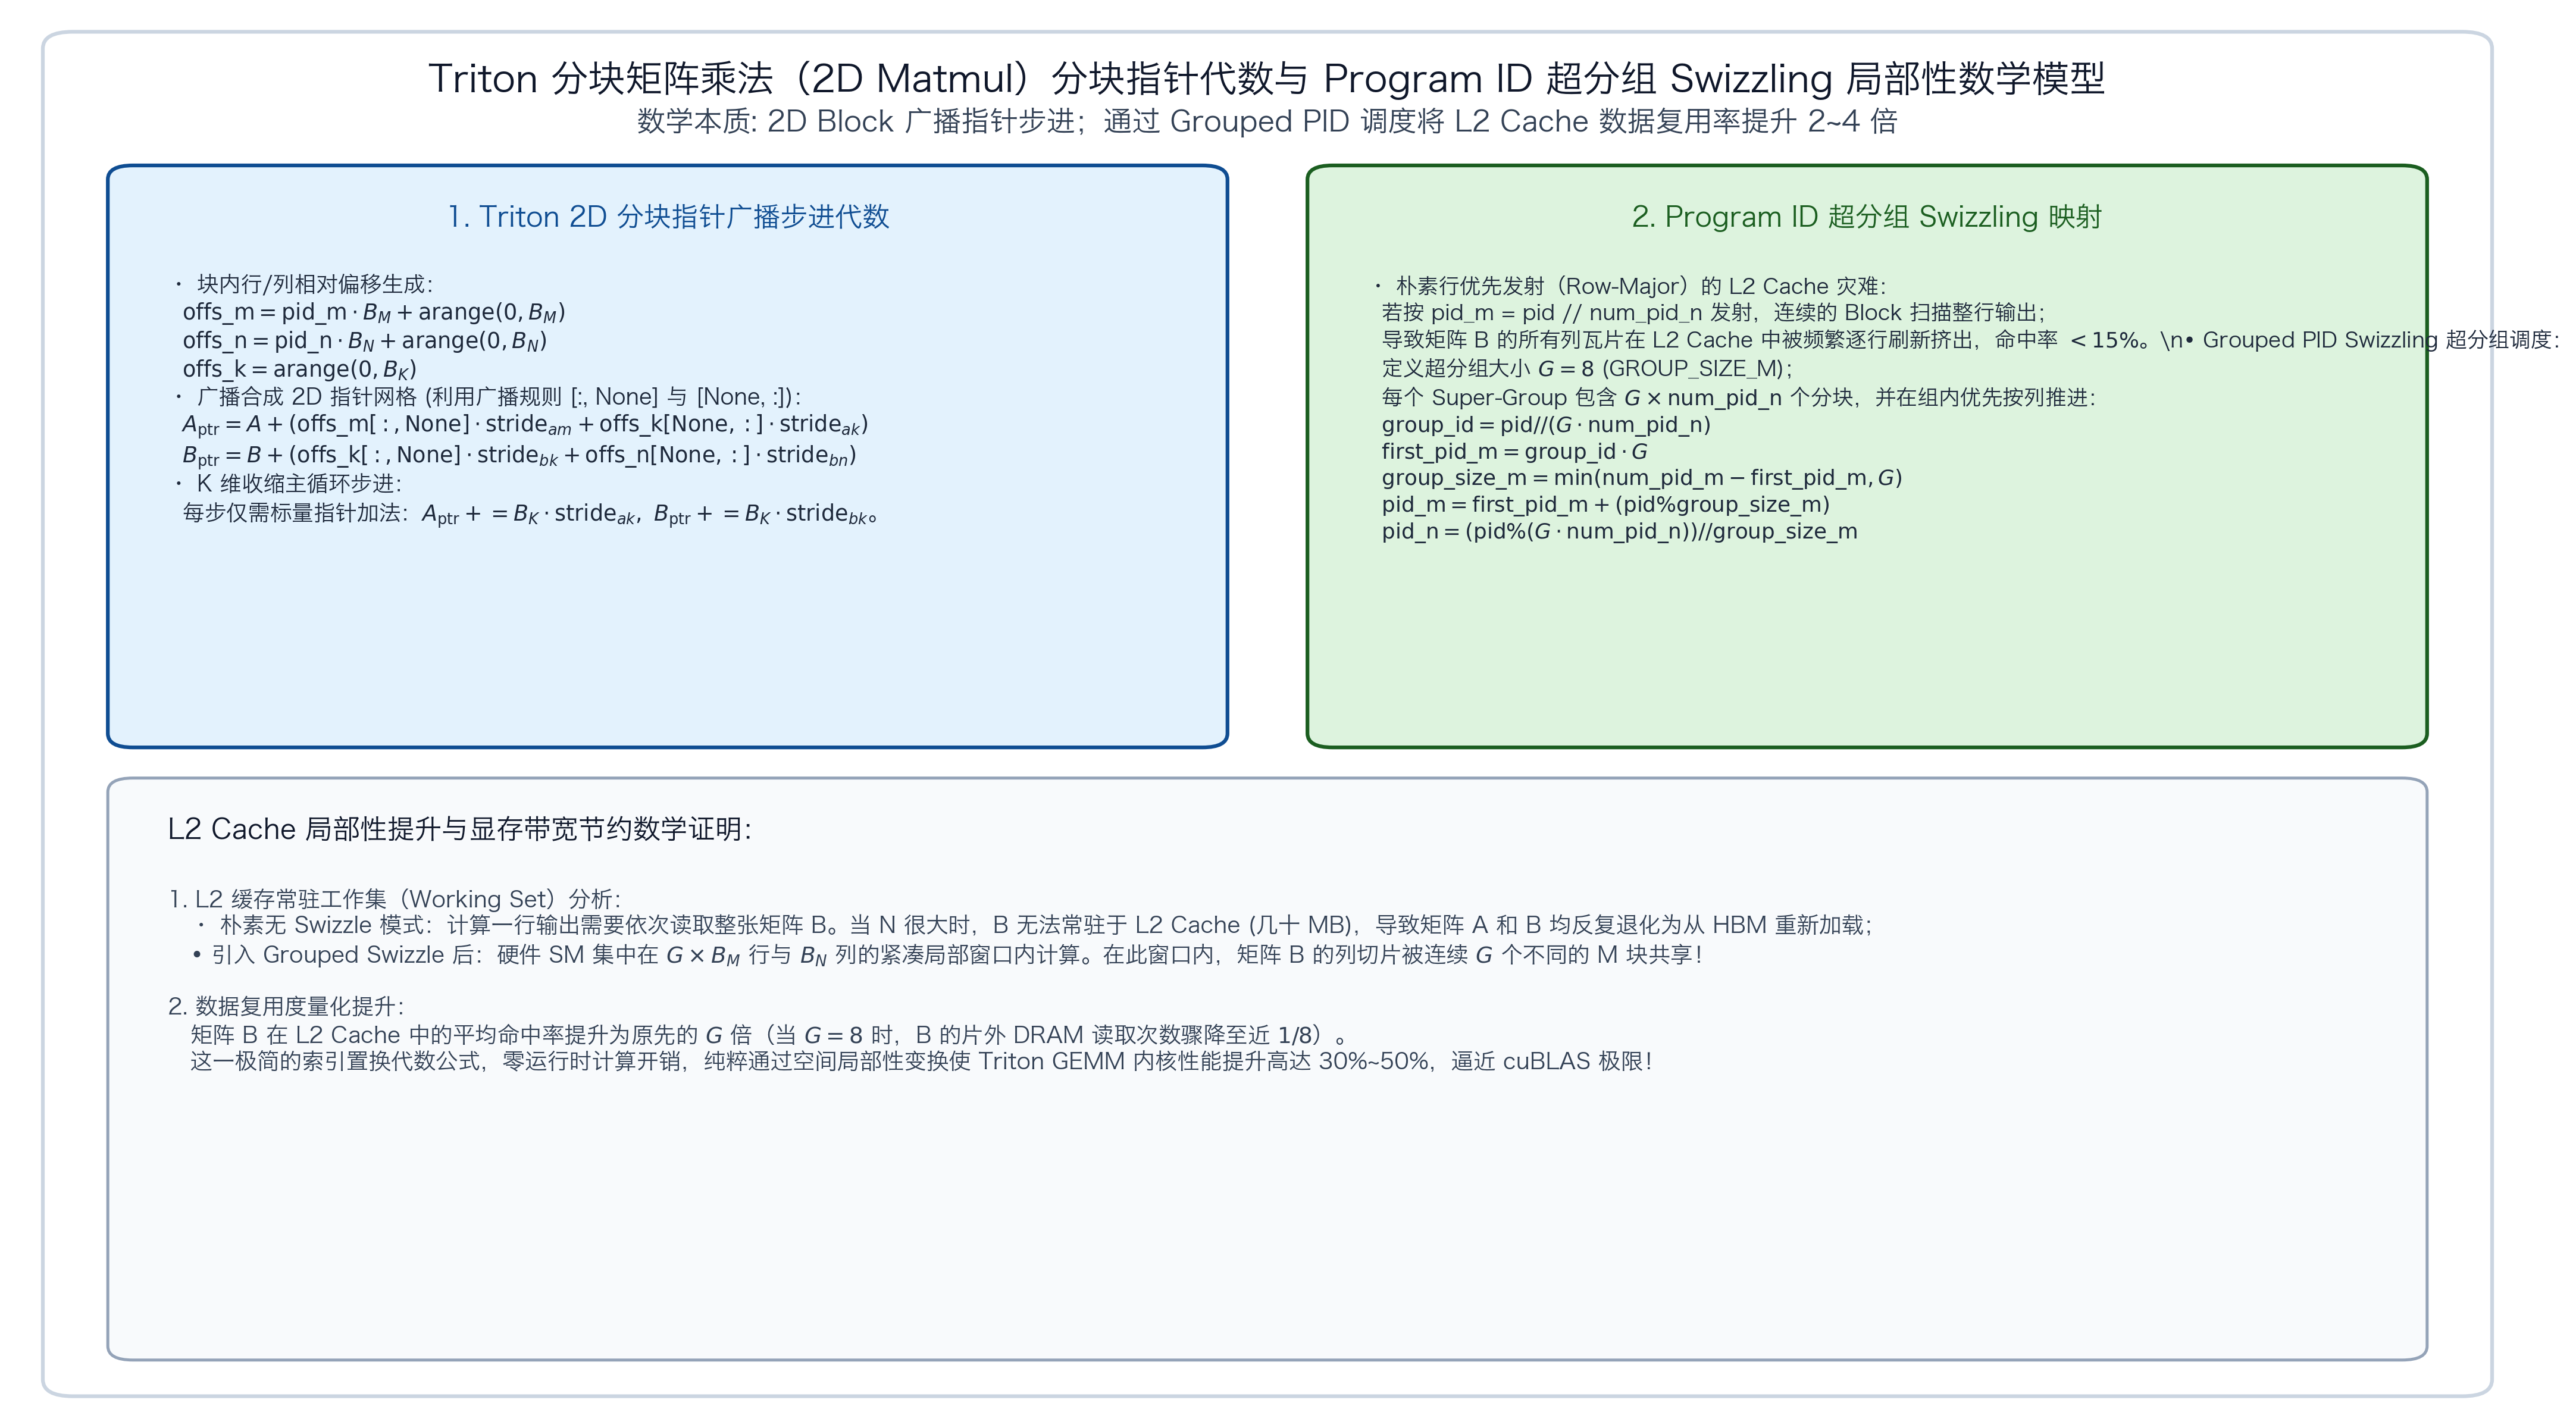
图 9-1:Triton 分块矩阵乘法(2D Matmul)分块指针代数与 Program ID 超分组 Swizzling 局部性数学模型
图 9-2:Blocked Matmul 瓦片乘法与 FP32 累加器保持精度架构
flowchart LR
    Init["初始化 acc = zeros((BLOCK_M, BLOCK_N), dtype=fp32)"] --> LoopK["K 维步进: 加载 A_tile 与 B_tile"]
    LoopK --> Mma["acc = tl.dot(A_tile, B_tile, acc)"]
    Mma --> Check{"K 轴遍历完毕?"}
    Check -->|否| LoopK
    Check -->|是| CastStore["转回 FP16/BF16 并写回 C[i, j]"]
图 9-3:Blocked Matmul K 维分块遍历累加流水线
累加器初始化: 每个 Program 处理输出的一个 子矩阵。在寄存器中初始化 FP32 全零矩阵:
acc = tl.zeros((BM, BN), tl.float32)K 维分块迭代与独立掩码保护: 内层循环以 为步长推进:
for k0 in range(0, K, BK):- 加载 的当前瓦片 ,地址为
rm[:, None] * sam + rk[None, :] * sak,掩码必须同时约束 轴与 轴:mask = (rm[:, None] < M) & (rk[None, :] < K),越界处填充加法单位元other=0.0; - 加载 的当前瓦片 ,掩码同时约束 轴与 轴:
mask = (rk[:, None] < K) & (rn[None, :] < N),越界处同样填充other=0.0。
- 加载 的当前瓦片 ,地址为
Tensor Core 驱动的片上累加(
tl.dot): 执行acc += tl.dot(av, bv)。在底层,Triton 编译器将tl.dot编译为 NVIDIA 原生 Tensor Core 硬件指令(如 Hopper 上的wgmma或 Ampere 上的mma.sync.m16n8k16)。 输入矩阵以 FP16/BF16 载入并相乘,但累加在 FP32 寄存器中进行,从硬件层面保证了深层网络训练中成千上万次乘加的累积精度。截断与写回(Epilogue): 维循环结束后,累加器
acc携带完整的瓦片点积和。通过输出掩码(rm[:, None] < M) & (rn[None, :] < N)保护,将结果安全转换为目标数据类型(如 FP16)写回全局显存 。
3. 正确性条件与常见误区
K 维尾块遗漏掩码的累积污染: 若开发者仅在写回 时施加了 和 的掩码,却在内层循环加载 和 时遗漏了
rk < K的检查: 对于尾块( 不是 整数倍),tl.load会将 维度之后的非法显存脏数据读入寄存器。经过 Tensor Core 乘积累加后,这些脏数据产生的外积结果会被永久熔铸进累加器acc中。即使在写回时做了输出掩码,算出的数值也已经是彻底错误的。混合精度累加溢出陷阱: 若累加器初始化为 FP16(
tl.zeros((BM, BN), tl.float16)),在 较大(如 )时,连续累加会导致 FP16 范围溢出(最大值仅 65504)或极严重的下溢与截断误差。必须严格遵循“低精度输入计算、高精度 FP32 累加”黄金法则。浮点结合律与容差预期: 由于 GPU Tensor Core 的并行点积顺序与 CPU 上的串行双精度循环截然不同,浮点加法不满足严格结合律,因此断言比较必须留有适当的相对容差(如
atol=2e-2, rtol=2e-2),不能按位要求 bitwise-exact。
4. 性能与工程取舍
- Tile 形状与流水线深度(
BM, BN, BK,num_warps,num_stages): Triton GEMM 的性能极度依赖超参数选择:(BM, BN, BK)决定了每个 Program 的计算强度与片上寄存器消耗;num_stages决定了使用共享内存软件流水线(Async Pipeline,如cp.async)预取的循环级数,通常 3~4 级最佳;num_warps(4 或 8)决定了 SM 上的指令级并发度。
- 训练 GEMM(大 M)与推理 Decode GEMV(M=1)的极化差异: 在 大模型预训练或 Prefill 阶段, 较大(如 ),属于典型的计算密集型(Compute-bound),需要选择大 Tile(如 )打满 Tensor Core; 但在自回归推理解码(Decode)阶段,每次仅输入 1 个 Token(),算子退化为矩阵-向量乘法(GEMV),极度受限于显存带宽(Memory-bound)。此时若强行使用大 Tile 会导致 99% 的 Program 空转,必须采用专门针对 优化的 Split-K GEMV 内核。
具体演示
以 、分块大小 为例:
- 网格发射 个 Program。
- K 维循环迭代: 轮。
- 第 1 轮():。 掩码有效范围为 , 掩码有效范围为 。
tl.dot累加前 32 个通道的有效点积。 - 第 2 轮():。 仅有第 32 这一列有效,后 31 列越界!由于指定了
other=0.0, 和 的后 31 个切片全被填充为 0.0。tl.dot仅计算第 32 通道的有效乘加,多余维度的 累加不改变精度。
- 第 1 轮():。 掩码有效范围为 , 掩码有效范围为 。
- 最终写回仅输出前 区域,全边界尾块数学解位级正确。
请在阅读后先合上这一节,用自己的语言复述“输入状态 → 中间状态 → 输出状态”,再做练习。
实践任务:唯一代码填空题
补齐 K-tile 累加。
规则:只能修改 TODO/______ 所在位置;不要删除断言或放宽误差。代码注释说明了每个边界条件。
Code
import torch
import triton
import triton.language as tl

@triton.jit
def matmul_kernel(a, b, c, M: tl.constexpr, N: tl.constexpr, K: tl.constexpr,
                  sam: tl.constexpr, sak: tl.constexpr,
                  sbk: tl.constexpr, sbn: tl.constexpr,
                  scm: tl.constexpr, scn: tl.constexpr,
                  BM: tl.constexpr, BN: tl.constexpr, BK: tl.constexpr):
    rm = tl.program_id(0) * BM + tl.arange(0, BM)
    rn = tl.program_id(1) * BN + tl.arange(0, BN)
    acc = tl.zeros((BM, BN), tl.float32)
    for k0 in range(0, K, BK):
        rk = k0 + tl.arange(0, BK)
        av = tl.load(a + rm[:, None] * sam + rk[None, :] * sak,
                     mask=(rm[:, None] < M) & (rk[None, :] < K), other=0.0)
        bv = tl.load(b + rk[:, None] * sbk + rn[None, :] * sbn,
                     mask=(rk[:, None] < K) & (rn[None, :] < N), other=0.0)
        acc += ______  # TODO: tile 矩阵乘
    tl.store(c + rm[:, None] * scm + rn[None, :] * scn, acc,
             mask=(rm[:, None] < M) & (rn[None, :] < N))

def matmul(a, b):
    assert a.ndim == b.ndim == 2 and a.shape[1] == b.shape[0]
    M, K = a.shape; N = b.shape[1]
    c = torch.empty((M, N), device=a.device, dtype=a.dtype)
    grid = (triton.cdiv(M, 32), triton.cdiv(N, 32))
    matmul_kernel[grid](a, b, c, M, N, K, *a.stride(), *b.stride(), *c.stride(),
                        BM=32, BN=32, BK=32)
    return c

for shape in ((17, 33, 19), (64, 64, 64)):
    M, K, N = shape
    a = torch.randn((M,K), device="cuda", dtype=torch.float16)
    b = torch.randn((K,N), device="cuda", dtype=torch.float16)
    torch.testing.assert_close(matmul(a,b), a@b, atol=2e-2, rtol=2e-2)
检查方法
在 CUDA/Triton 环境运行本单元格;断言覆盖规则尺寸和非规则尾块。首次 JIT 不计入性能。
提交时请给出:补齐后的代码、实际运行输出(环境不可用时注明“仅静态审查”)以及对失败用例的解释。
Q1
不要背定义:请从输入、状态变化和输出三个阶段解释“Blocked Matmul 与 FP32 累加”的工作机制。
你的答案:
Q2
只 mask 输出而不 mask K 尾块会怎样?
你的答案:
Q3
为什么训练 GEMM 与 decode 的 M=1 GEMM 不应共用同一配置?
你的答案:
评分与通过规则
- 代码 4 分:正常输入 2 分,边界输入 1 分,解释实现 1 分;
- Q1~Q3 各 2 分;
- 一票否决:结果碰巧正确但核心因果链错误、删除边界检查、把未运行结果说成实测。
需要提示时按四级机制请求:概念区域 → 具体方向 → 关键局部 → 完整答案。