flowchart TD
    subgraph Frontend["API Server / Frontend"]
        AsyncLLM["AsyncLLM 异步服务接口"]
        ReqQueue["输入请求队列 (Input Queue)"]
    end
    subgraph Core["EngineCore (单事件循环单线程)"]
        Scheduler["Unified Scheduler (统一调度器)"]
        KVManager["KVCacheManager (显存块分配)"]
    end
    subgraph Backend["分布式 Worker 集群 (WorkerPool)"]
        W0["ModelRunner (GPU 0 - TP Rank 0)"]
        W1["ModelRunner (GPU 1 - TP Rank 1)"]
    end
    AsyncLLM -->|ZMQ / IPC 无锁通道| Core
    Scheduler & KVManager -->|发送执行指令| Backend
第 1 课:vLLM V1 源码地图:AsyncLLM、EngineCore 与 Worker
参考答案版:包含完整代码实现与问答题深度参考解析。建议先独立完成练习题后再展开核对。
本课目标与通过标准
本课产出:能从在线请求入口沿真实调用链追到一次模型执行和输出回传,并准确说明 frontend、EngineCore、Scheduler、Executor/Worker 的状态所有权。
通过要求:唯一代码填空题通过全部断言;Q1~Q3 都能沿源码对象给出因果链;能指出一个正确性不变量、一个性能边界和一个需要 benchmark 才能确认的结论;总分至少 8/10。
源码版本与阅读方法
本课程使用固定 commit 的永久链接保证行号可复现,同时链接 current docs 供核对最新变化。阅读时先画调用图和状态所有权,再进入分支;不要从大文件第一行机械顺读。
本课按下面顺序阅读,不要从 2500 行的 core.py 第一行顺读:
| 顺序 | 文件与入口 | 带着什么问题读 |
|---|---|---|
| 1 | vllm/v1/engine/async_llm.py:AsyncLLM.generate、_add_request、_run_output_handler |
谁负责 tokenization、请求流和客户端取消? |
| 2 | vllm/v1/engine/core.py:EngineCore.step |
一次迭代为何是 schedule → execute → update? |
| 3 | core.py:EngineCoreProc.run_busy_loop、_process_engine_step |
frontend 与 engine core 为什么分进程? |
| 4 | vllm/v1/core/sched/interface.py:SchedulerInterface |
scheduler 的输入输出合同是什么? |
| 5 | vllm/v1/worker/gpu_model_runner.py |
哪些状态必须在 GPU worker 内,哪些不能由 frontend 猜? |
源码快照:vLLM 8e958902eee5。方法会继续演进,面试回答应先声明所读版本。
核心心智模型
1. 它是什么,解决什么问题
vLLM V1 架构是大语言模型高并发推理领域最具代表性的重构工程范式。在早期的 vLLM V0 架构中,Python 全局解释器锁(GIL)瓶颈明显、调度逻辑与异步 HTTP 事件循环深层交织,导致在单步耗时仅需数毫秒的轻量 Decode 场景中,CPU 侧的调度开销往往超过了 GPU 的计算耗时,引发严重的“GPU 算力饥饿等待 CPU 调度”的瓶颈。
为了攻克这一系统瓶颈,vLLM V1 确立了严格的三层解耦架构(图 1-2):
图 1-2:vLLM V1 三层解耦核心架构 (Frontend → EngineCore → Workers)
AsyncLLM(前端服务层):面向客户端的异步 HTTP/gRPC/SSE 接入网关,负责请求接入、Tokenization 分词、流式输出解包与取消信号监听;EngineCore/EngineCoreProc(调度核心内核层):运行在完全物理隔离的独立进程中,由单事件循环主导,独占全局请求生命周期调度器(Scheduler)与显存逻辑账本(KVCacheManager);Worker/GPUModelRunner(设备执行层):由分布式并行(TP/PP)驱动的执行引擎,独占物理 GPU 张量、物理 KV Block 内存池与 CUDA Graph 捕获环境。
它解决的核心工程问题是:通过清晰的单写者状态所有权(Single-Writer State Ownership)与轻量化 IPC 进程解耦,将 CPU 控制侧的每步调度耗时压制在微秒级,实现调度步频与 GPU 硬件峰值吞吐的完全匹配。
2. 它如何工作
端到端请求流转与核心控制循环如图 1-1 至图 1-3 所示:
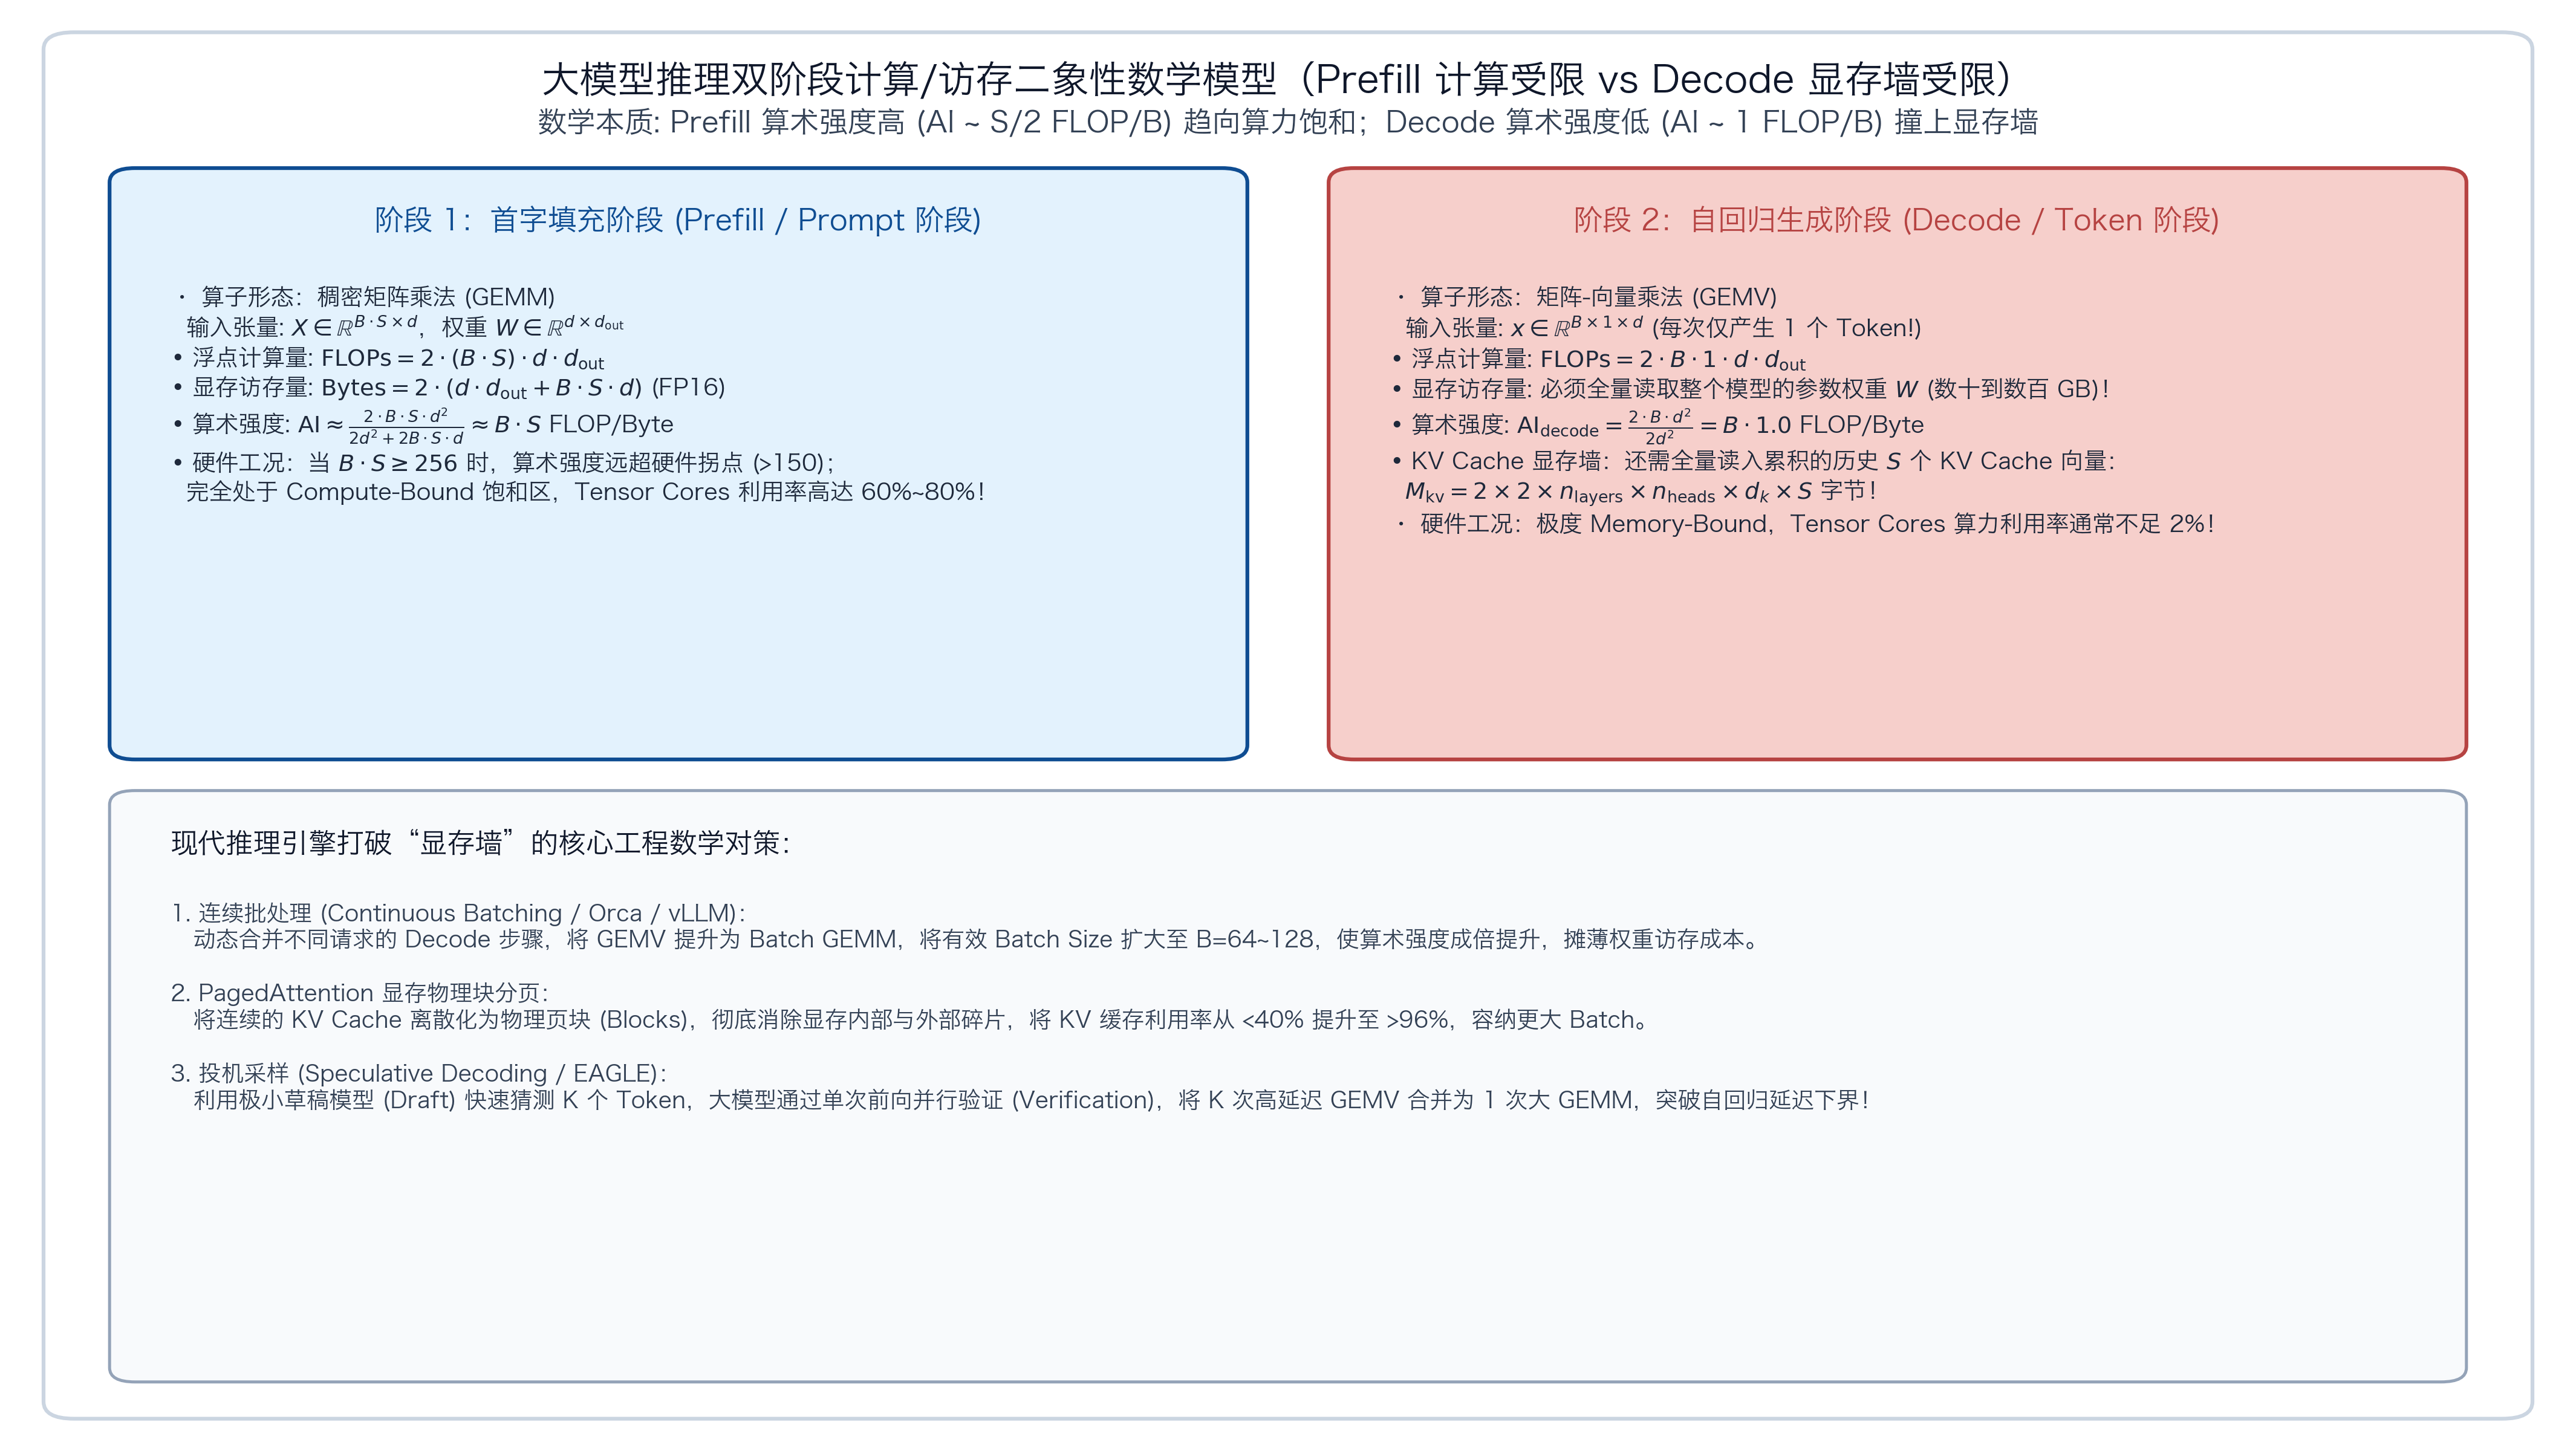
图 1-1:大模型推理双阶段计算/访存二象性数学模型(Prefill 计算受限 vs Decode 显存墙受限)
- 三段式步进迭代循环(Schedule Execute Update): 在
EngineCore.step()内部,系统严格遵循严谨的时序管道:- 调度阶段(Schedule):
Scheduler消费输入队列,根据全局 Token 预算(Token Budget)生成本次批次的执行计划plan = scheduler.schedule(); - 异步发射与计算重叠(Async Execute & Overlap):通过
model_executor.execute_model(plan, non_block=True)非阻塞地向 GPU Worker 广播执行指令。在 GPU 执行 Heavy GEMM 与 Attention 的微小间隙,CPU 主线程并发执行结构化输出的 Grammar 状态机掩码提取; - 等待同步与取消处理(Wait & Abort Drain):同步等待 Worker 的
future()返回本次推理结果;在应用输出前,优先消费清空执行期间积累的取消请求队列process_aborts(); - 状态递推更新(Update):调用
scheduler.update_from_output(plan, model_output),更新每个请求的已计算 Token 计数并回收已完结请求的逻辑 KV 块。
- 调度阶段(Schedule):
- 端到端流水线推进(图 1-3):
flowchart LR
    Req["HTTP 请求到达"] --> Tokenize["分词器编码 Tokens"]
    Tokenize --> PutReq["压入 EngineCore 请求队列"]
    PutReq --> Step["EngineCore::step() 统一调度决策"]
    Step --> Forward["GPU ModelRunner 并行前向推理 (TP AllReduce)"]
    Forward --> Detokenize["采样器输出 Token 解码并流式回传 SSE"]
图 1-3:vLLM V1 端到端请求流转与异构协同执行流水线
HTTP 请求到达后,AsyncLLM 完成异步分词,将 EngineCoreRequest 推入无锁共享内存队列;EngineCore 批量消费并驱动 GPU ModelRunner 并发前向传播;采样完成后的 Token 结果以流式事件(SSE)的形式逆向实时推送回前端。
3. 正确性条件与常见误区
严格的单写者状态所有权(Single Writer Discipline): 整个系统中每个核心对象的状态拥有唯一的权威写入者:
AsyncLLM独占流式传输通道与输入请求缓冲,严禁越权修改内部 KV 账本;EngineCore与Scheduler独占跨步请求生命周期(Waiting, Running, Swapped, Finished),严禁 Worker 擅自更改请求状态;GPUModelRunner独占物理显存与算子 Kernel 执行。若跨进程试图共享可变全局对象,会导致灾难性的数据竞争与状态错位。
Abort 取消处理的原子时序边界: 若请求在 GPU 执行前向传播期间被客户端主动取消(如用户关闭网页),
EngineCore必须在调用scheduler.update_from_output之前彻底消费并处理取消信号!若顺序颠倒(先更新再取消),模型刚生成的 Token 会被误推送给已断开的客户端,甚至引起已被释放的物理 Block 发生二次读写踩内存。计划与执行结果的版本一致性不变量:
SchedulerOutput与ModelRunnerOutput必须严格属于同一个迭代步骤。严禁在 Worker 执行失败时返回伪造的静默空输出,必须通过强类型异常驱动全局容错与降级。
4. 性能与工程取舍
进程解耦带来的 IPC 序列化开销 vs GIL 消除红利: 将 EngineCore 独立为子进程彻底释放了 Python GIL 的并发阻塞,但引入了进程间通信开销。vLLM V1 采用极简的扁平 C-struct 内存布局与共享内存(Shared Memory)通道,将跨进程数据传输延迟压缩至十微秒级,使架构收益显著超越通信开销。
Grammar 准备与 GPU 计算的精妙重叠: 在 JSON 等强约束解码(Structured Outputs)中,计算下一个合法 Token 的 Bitmask 极其消耗 CPU 算力。通过在
execute_model(non_block=True)发射后立即开始计算 Grammar,系统完美地将 CPU 纯逻辑与 GPU 算力执行掩盖在同一时序窗口内,实现了近乎零气泡的控制流水线。
具体演示:单请求执行取消与控制流跟踪演练
考虑一个典型的并发取消场景:
请求 被调度进入当前批次,调度计划为
{"scheduled_tokens": 4};系统调用
execute_async向 GPU 发射异步推理任务,GPU 开始执行前向注意力计算;在 GPU 计算尚未结束的窗口内,客户端由于超时断开了 HTTP 连接,取消信号进入待处理队列;
核心调度流程执行控制:
- 首先执行
grammar = get_grammar(plan),准备下一 Token 约束; - 随后执行
future()阻塞等待 GPU 输出; - 关键时序点:在得到
model_output后,必须立刻执行process_aborts(),将 标记为已取消; - 最后执行
update(plan, model_output):调度器感知到 已被取消,安全丢弃其输出 Token 并直接回收其持有的 KV Cache Block,绝不会将废弃数据向前端泄露。
- 首先执行
断言 trace 序列严格保持:["schedule", "execute", "grammar", "wait", "aborts", "update"],完整闭环。
实践任务:唯一代码填空题
补齐一个最小 EngineCore.step 控制流模型。重点不是模拟 GPU,而是保持官方源码中的顺序合同;不得删除 trace 断言。
只能修改 TODO/______ 位置,不得删除断言或放宽通过条件。
Code
def engine_core_step(has_requests, schedule, execute_async,
                     get_grammar, process_aborts, update):
    trace = []
    if not has_requests:
        return {}, False, trace

    # TODO:保持 schedule → async execute/grammar → wait → aborts → update。
    plan = ______
    trace.append("schedule")
    future = ______
    trace.append("execute")
    grammar = ______
    trace.append("grammar")
    model_output = ______
    trace.append("wait")
    ______
    trace.append("aborts")
    outputs = ______
    trace.append("update")
    return outputs, plan["scheduled_tokens"] > 0, trace

events = []
schedule = lambda: {"scheduled_tokens": 4}
execute = lambda plan: (lambda: {"tokens": [7]})
grammar = lambda plan: {"mask": None}
aborts = lambda: events.append("abort-queue-drained")
update = lambda plan, output: {"r0": output["tokens"]}

out, ran, trace = engine_core_step(True, schedule, execute, grammar, aborts, update)
assert out == {"r0": [7]} and ran
assert trace == ["schedule", "execute", "grammar", "wait", "aborts", "update"]
assert events == ["abort-queue-drained"]
assert engine_core_step(False, schedule, execute, grammar, aborts, update) == ({}, False, [])
检查方法
运行断言;再让 scheduled_tokens=0,解释为什么仍可能走完控制路径但 ran=False。
Q1
AsyncLLM、EngineCore、Scheduler 和 GPU worker 各自拥有什么状态?为什么不能把它们合成一个全局可变对象?
你的答案:
Q2
为什么源码先 execute_model(non_block=True),再取得 grammar bitmask,最后等待 future?这是否意味着 grammar 可以晚于采样?
你的答案:
Q3
某请求在 GPU forward 期间被取消。为何 EngineCore.step 要在 update_from_output 前处理 abort?
你的答案:
评分规则
- 代码 4 分:主路径 2 分、边界条件 1 分、能映射回源码对象 1 分;
- Q1~Q3 各 2 分:必须包含对象、状态变化、正确性或成本链;
- 一票否决:把论文峰值写成普遍生产结论;把源码支持写成所有模型/硬件可用;混淆算法正确性与性能;只背类名而说不清状态所有权。